TesboFlow
أيام من حسابات CFD،تنتهي قبل الغداء.
خط الأنابيب كلّه يعيش على الـ GPU. لا خطوة تنتظر المعالج المركزي.
100 مليون خلية. خطوة واحدة. ثانية واحدة.
مُقاس: 110.6 مليون خلية · 8×A100 · 1.5 ث/خطوة
0×
مقابل نواة CPU واحدة
0×
مقابل 18 نواة CPU
المنتجات
أربعة منتجات. حلقة CFD واحدة.
حلّالان على GPU، ومولّد شبكات يكتب شبكة TesboFlow الأصلية، وذكاء اصطناعي في المسار نفسه.
TesboFlow · مُقاس
الأداء
بهذه السرعة أصلًا. على هذا العتاد. على هذه الشبكات.
- 0×
- مقابل نواة CPU واحدة
- 0×
- مقابل 18 نواة CPU
- 0.0 s
- 110 ملايين خلية، خطوة واحدة
هدف المجموعة يبقى 1,000×، وتشغيلًا نموذجيًا في عشر دقائق، و1 → N من كروت GPU ببناء واحد.
مُقاس · TesboFlow، سبتمبر 2026
زمن الجدار لكل خطوة
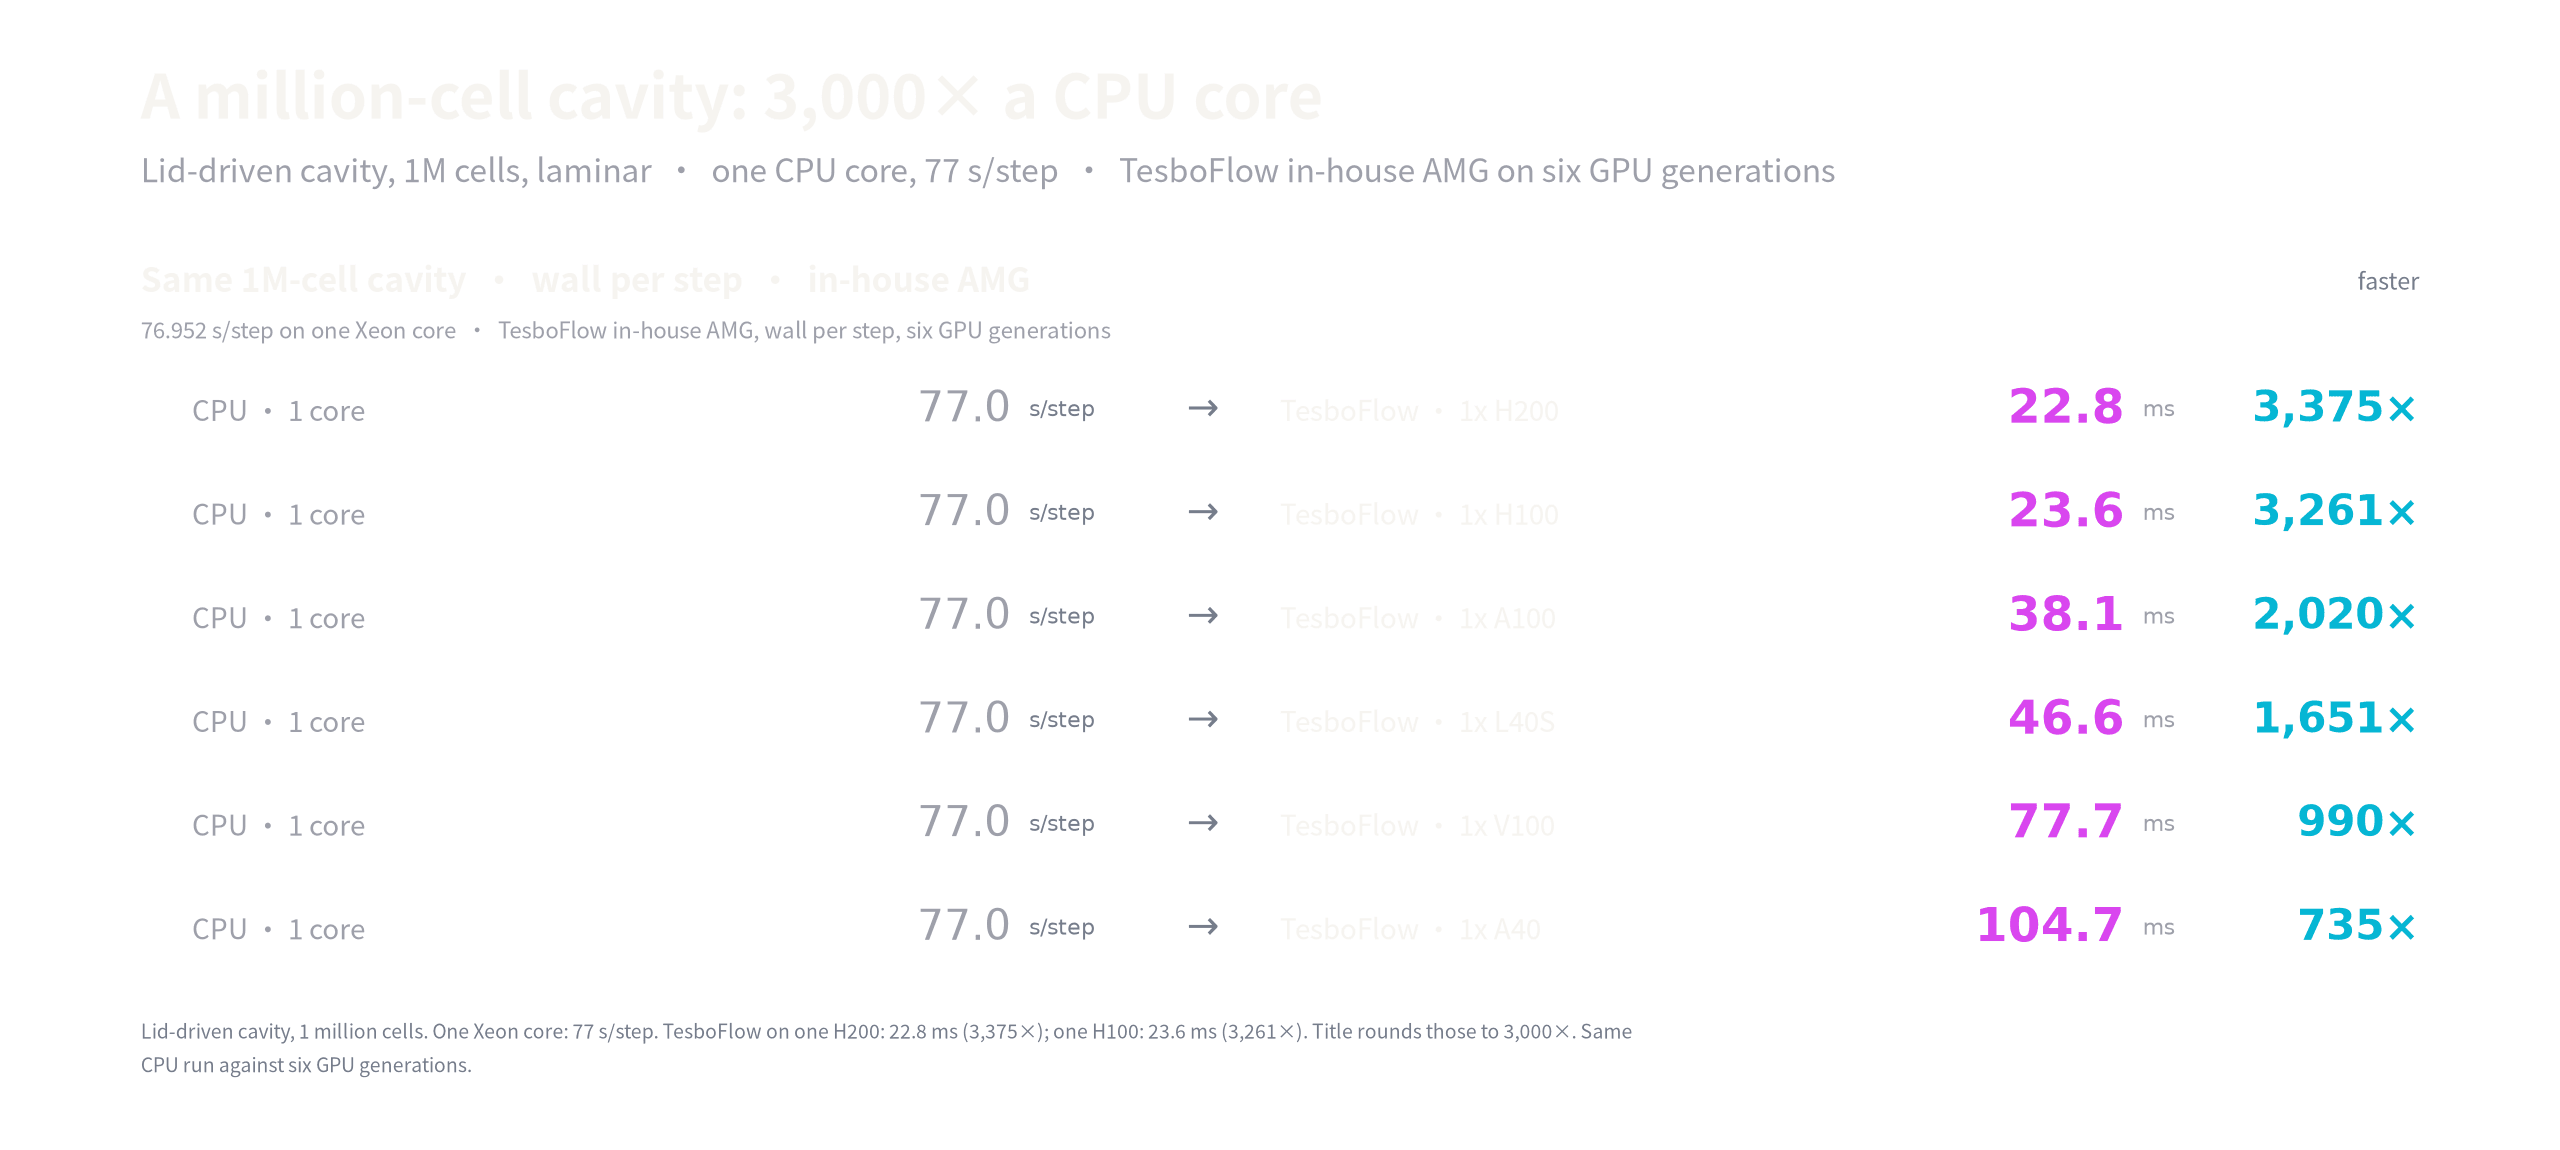
تجويف بمليون خلية، صفحي — نواة CPU واحدة مقابل GPU واحدة
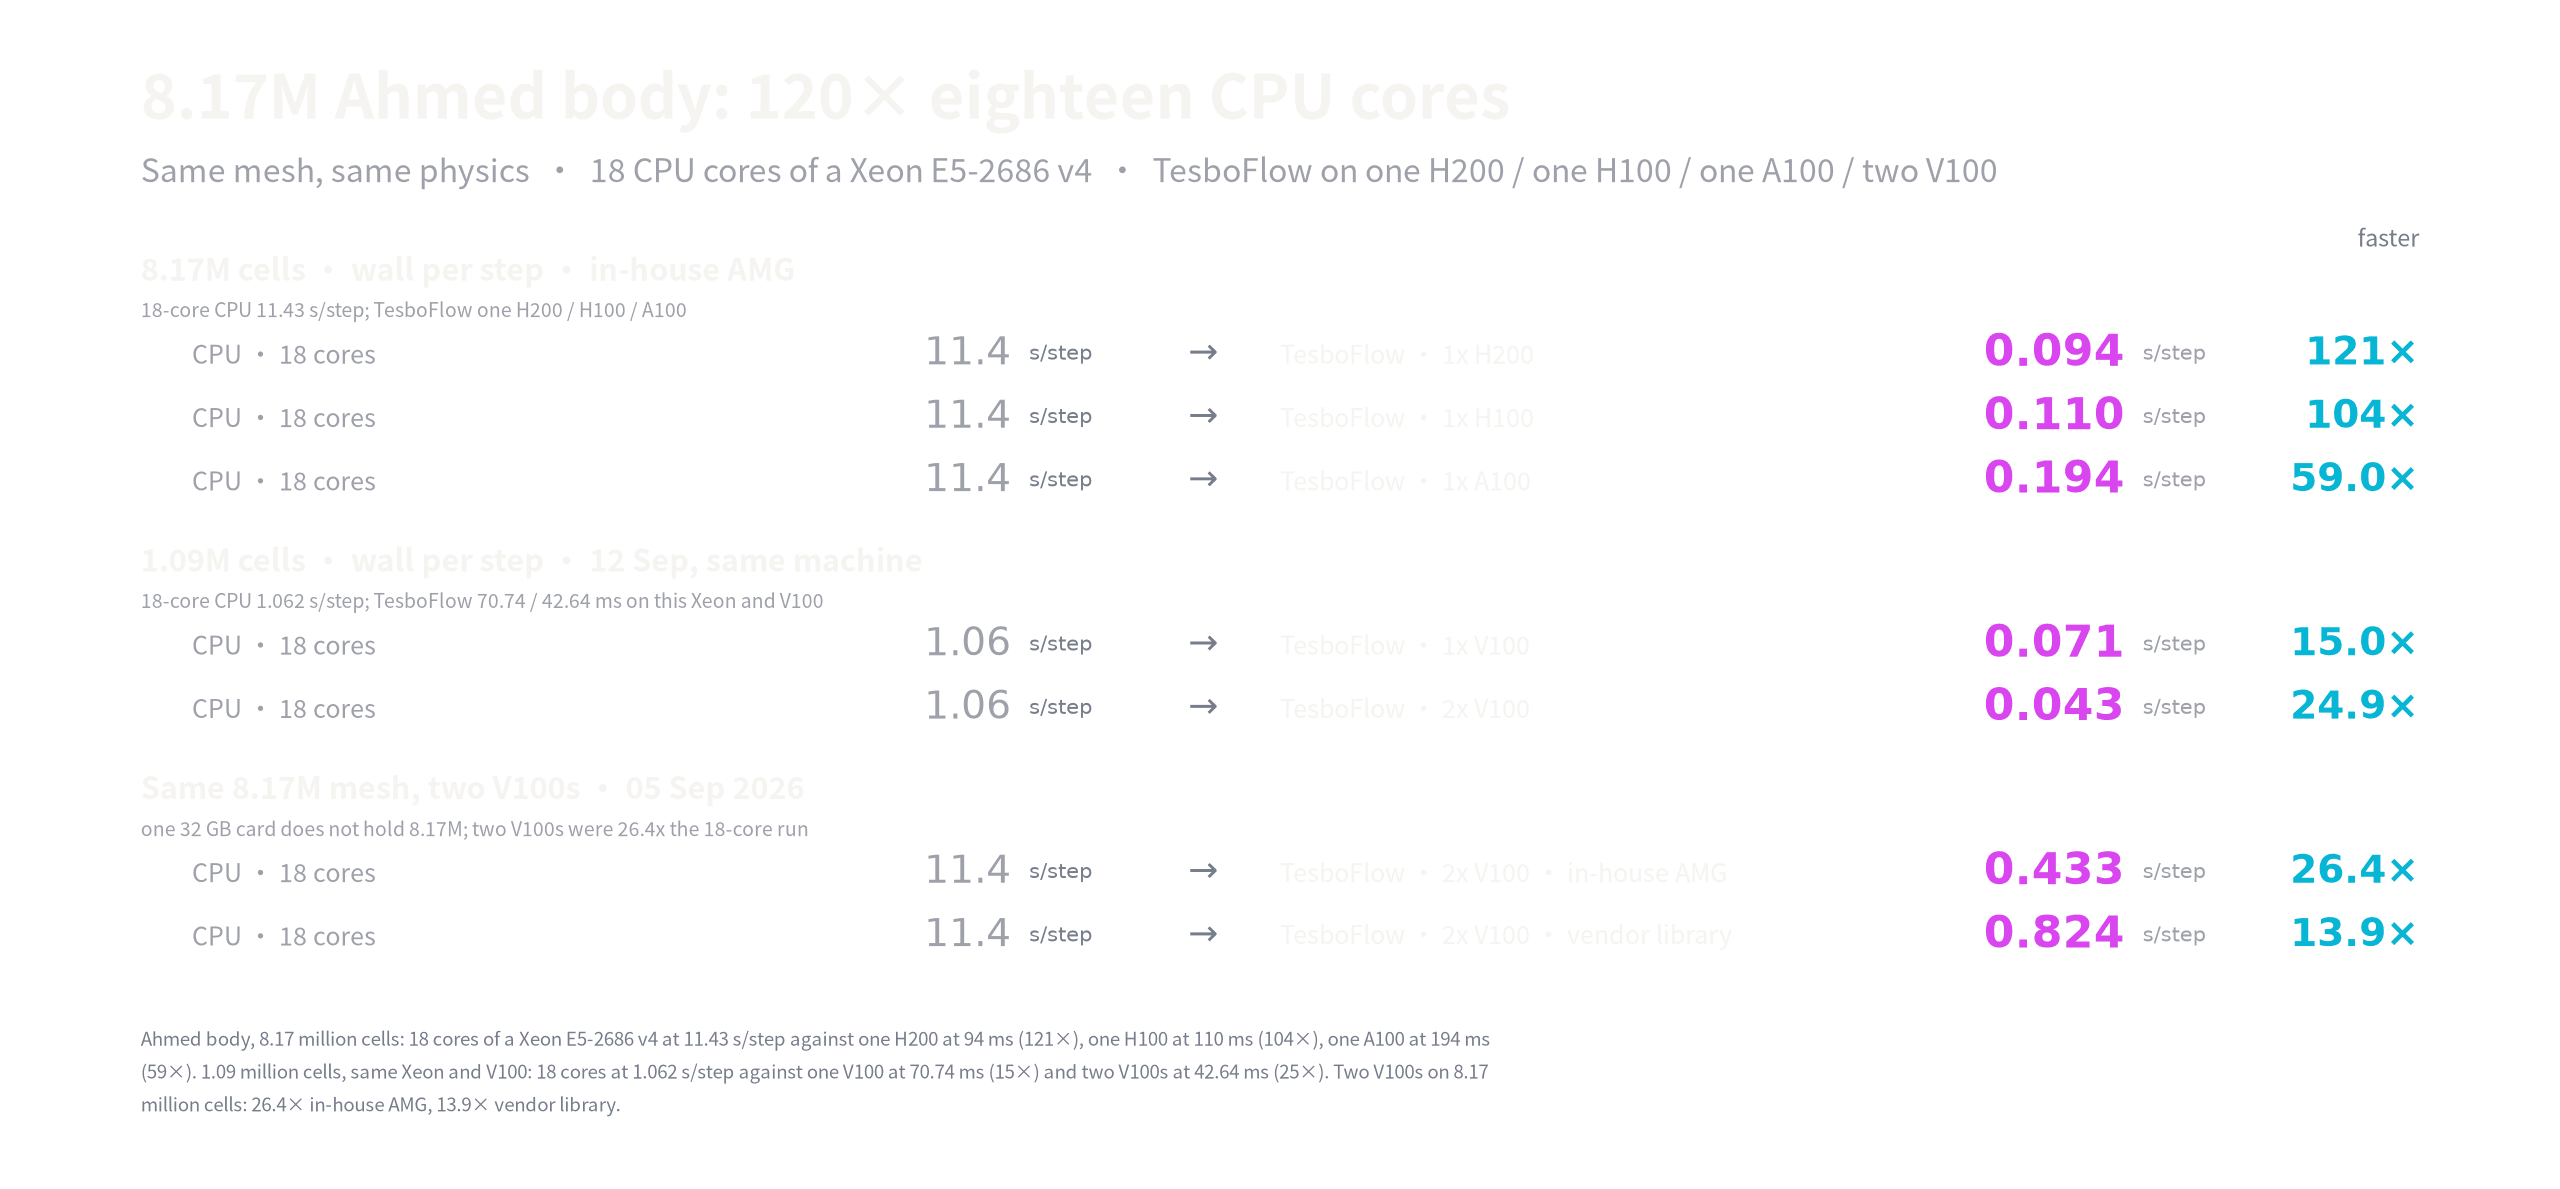
جسم أحمد 8.17 مليون، RANS مستقر — ثماني عشرة نواة مقابل GPU واحدة
100 مليون خلية. خطوة واحدة. ثانية واحدة.
110.6 مليون خلية · 8× A100 · 1.5 ث/خطوة
مُقاس: 1.5 ث/خطوة.
مشاهد نموذجية وليست عقدًا. 3,000×: تجويف بمليون خلية، نواة CPU واحدة، H200 واحدة عند 22.8 مللي ثانية. 100×: جسم أحمد 8.17 مليون، 18 نواة Xeon، H200 واحدة عند 94 مللي ثانية. 110.6 مليون خلية على 8×A100 عند 1.5 ث/خطوة.
TESBOLBM · مقيس
محاكاة الصبّ، بسرعة الـ GPU
- 0×
مقابل نواة معالج واحدة
1851 MLUPS على بطاقة Tesla V100 واحدة مقابل 4.1 MLUPS على نواة واحدة من الجهاز نفسه.
- 0×
مقابل عقدة المعالج كاملة
التشغيل ذاته على الـ GPU مقابل أنوية الجهاز الـ 18 كلّها عبر MPI، عند 33.9 MLUPS. وهذا هو الرقم الذي نذكره.
- 0.0×
على نواة التوصيل الحراري
5422 MLUPS مقابل 134 MLUPS على 36 خيطًا للمعالج، والطرفان ينفّذان الحساب ذاته.
جهاز واحد، وبطاقة Tesla V100 واحدة، والنواة ذاتها على الطرفين — دون تحجيم أو استقراء. ونسبة العقدة أدنى بكثير من نسبة النواة الواحدة لأنّ المعالج نفسه لا يكسب سوى 8.3× عبر أنويته الـ 18: فطريقة بولتزمان الشبكية محدودة بعرض نطاق الذاكرة، لا بسرعة الساعة.
حوسبة أسرع
بنية GPU أصلية
يشغّل TesboFlow خط أنابيب CFD بالكامل على GPU — الشبكة والحلّال والجبر الخطي والمعالجة اللاحقة. بدون اختناق CPU، بدون تكلفة نقل بيانات. حوسبة متوازية صرفة.
- بدون اختناق CPU
- توازي هائل
- عرض نطاق ذاكرة عالي
والنهج نفسه المعتمد على GPU يقوم عليه TesboLBM: الملء والتصلّب يعملان كذلك من البداية إلى النهاية على GPU.
استكشف TesboFlowلماذا TesboFlow
ليس نقلًا. حلّال حجوم منتهية أصلي على GPU، وصل أصلًا إلى هذه السرعة وعلى هذا العتاد وعلى هذه الشبكات.
AMG داخلي
أسرع وأوفر من NVIDIA AmgX. ألف تكرار: 35 ث و7 جول، مقابل 59 ث و11 جول.
زِد البطاقات. زمن الجدار ينخفض.
الشبكات التي لا تدخل بطاقة واحدة تظل أرخص عند إضافة المزيد. 56 مليون خلية، والبطاقات الإضافية تُجدي.
جسم أحمد · الأثر الاضطرابي · محسوب على GPU
نفق رياح Navier-Stokes في الزمن الحقيقي
اختبر ميكانيكا الموائع في الزمن الحقيقي مباشرةً في متصفحك. اختر شكل جناح جاهزاً، أو عائقاً أسطوانياً لتوليد الدوامات، أو ارسم حدوداً صلبة مخصصة بإصبعك لمراقبة تطوّر الدوامية وموجات الضغط.
TesboAI · أبحاث AI + CFD
ذكاءٌ في صميم الحلّال.
لأن المحرّك أصلي على الـ GPU، تتدرّب النماذج على بياناته وتعمل داخل ذاكرته. هذه نتيجة، لا وعد.
أنت
TesboAI
الخطأ النسبي L2 يساوي 0.194 · التفاوت 0.25
إعادة عرض جلسة — سؤال، وتغيير الشروط، ومقارنة المحاولات؛ وكل رقم يحسبه الحلّال على GPU.
نموذج بحثي قيد التطوير. إعادة عرض مختصرة لجلسة حقيقية — الجلسة الكاملة في صفحة TesboAI.
المحاكاة في عصر الـ GPU
مبنيّ للسرعة. مدفوع بالـ GPU.
السرعة ليست ميزة إضافية، بل هي ما يجعل المحاكاة قابلة للاستخدام فعلاً. فحين تأتي النتيجة في دقائق بدل أيام، يتوقّف المهندسون عن الانتظار ويبدؤون في الاستكشاف. لذلك نبني على الـ GPU من الأساس حتى يصبح هذا هو المعتاد.
وهذا سيغيّر العالم.
— Tesbo، مؤسس المشروع
عن TesboCFD
تطوّر TesboCFD تقنيات CFD أصلية على GPU من الجيل التالي للمحاكاة الهندسية والتصميم بمساعدة الذكاء الاصطناعي.
التعاون الأكاديمي والتحقق من صحة الحلّال