充型、传热与凝固,都在 GPU 上求解”
真实铸件
一个完整的铸造周期,跑在生产零件上
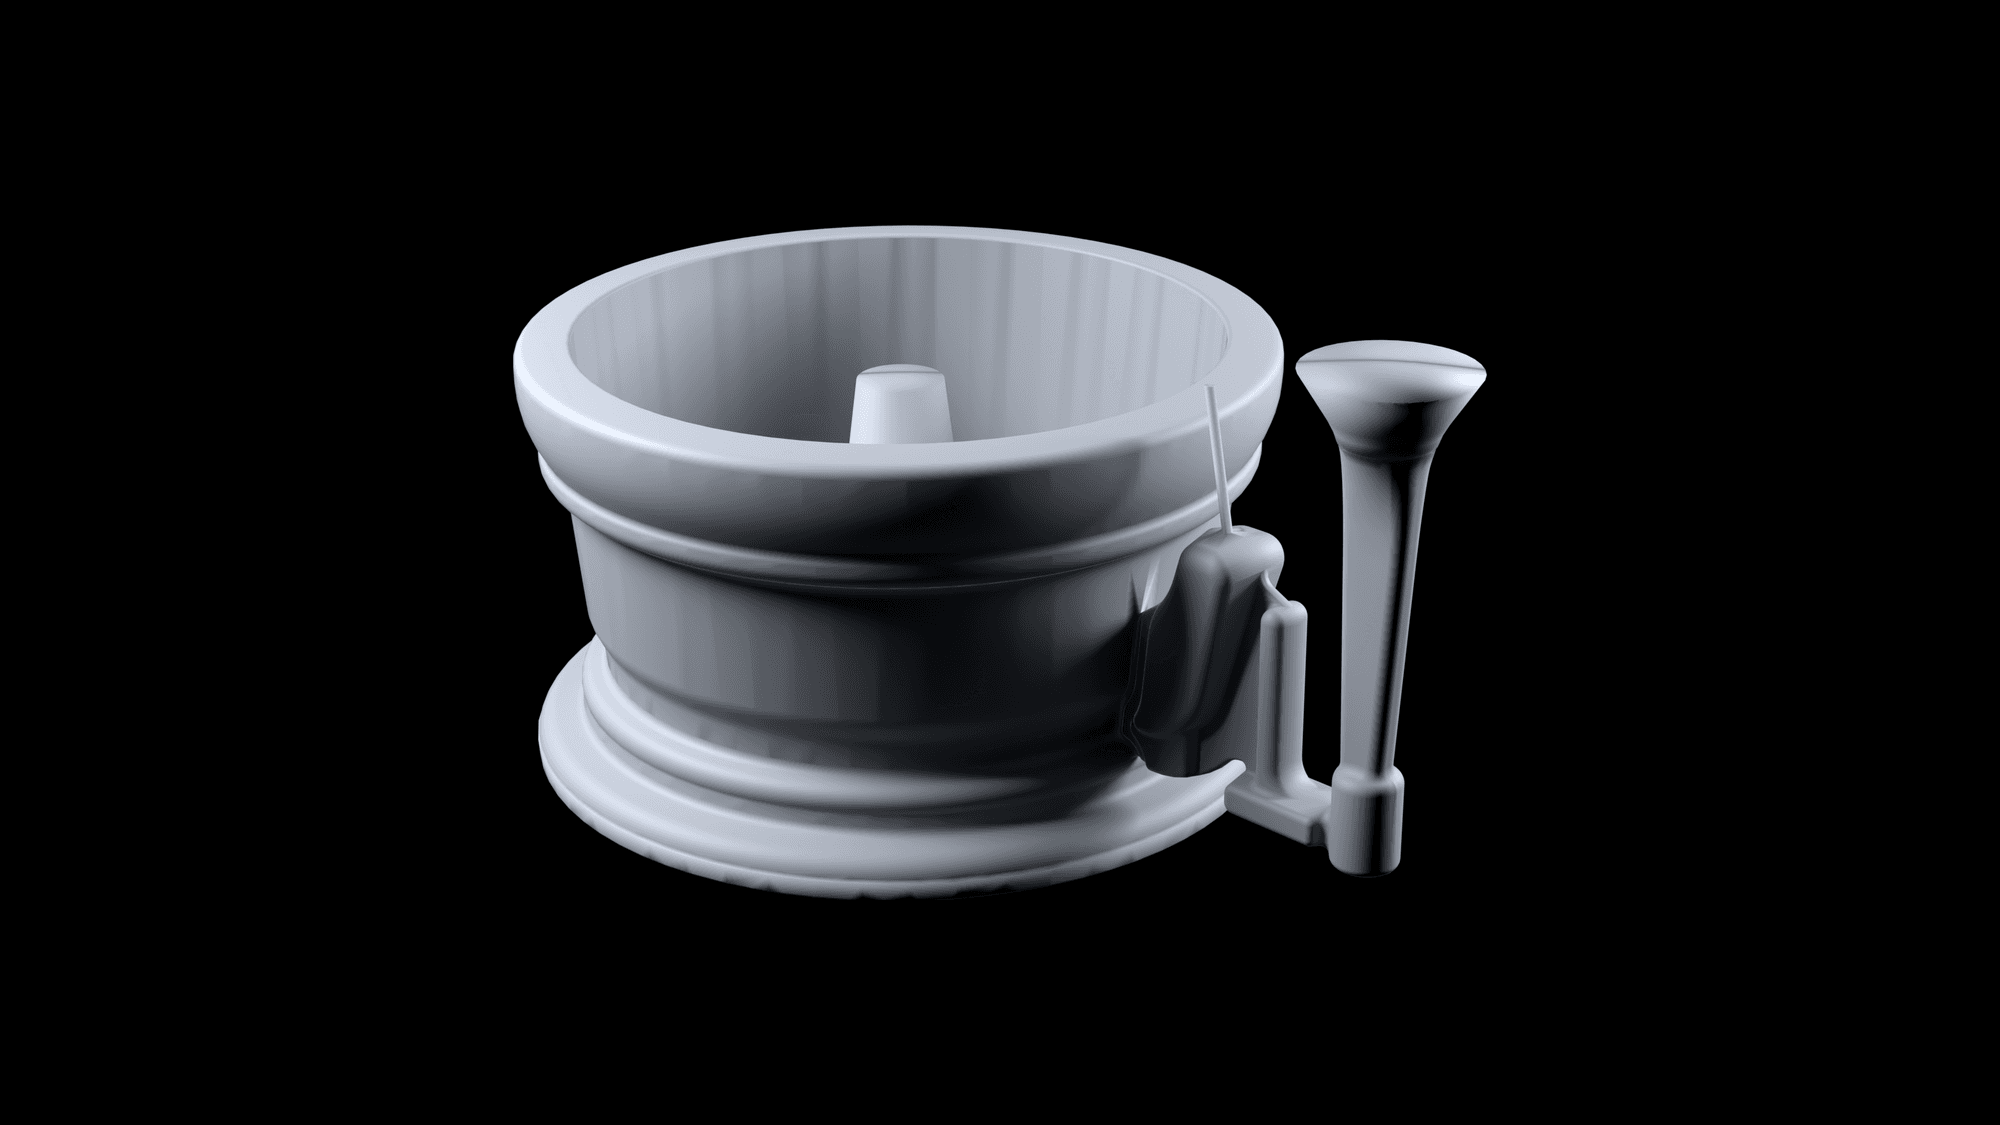
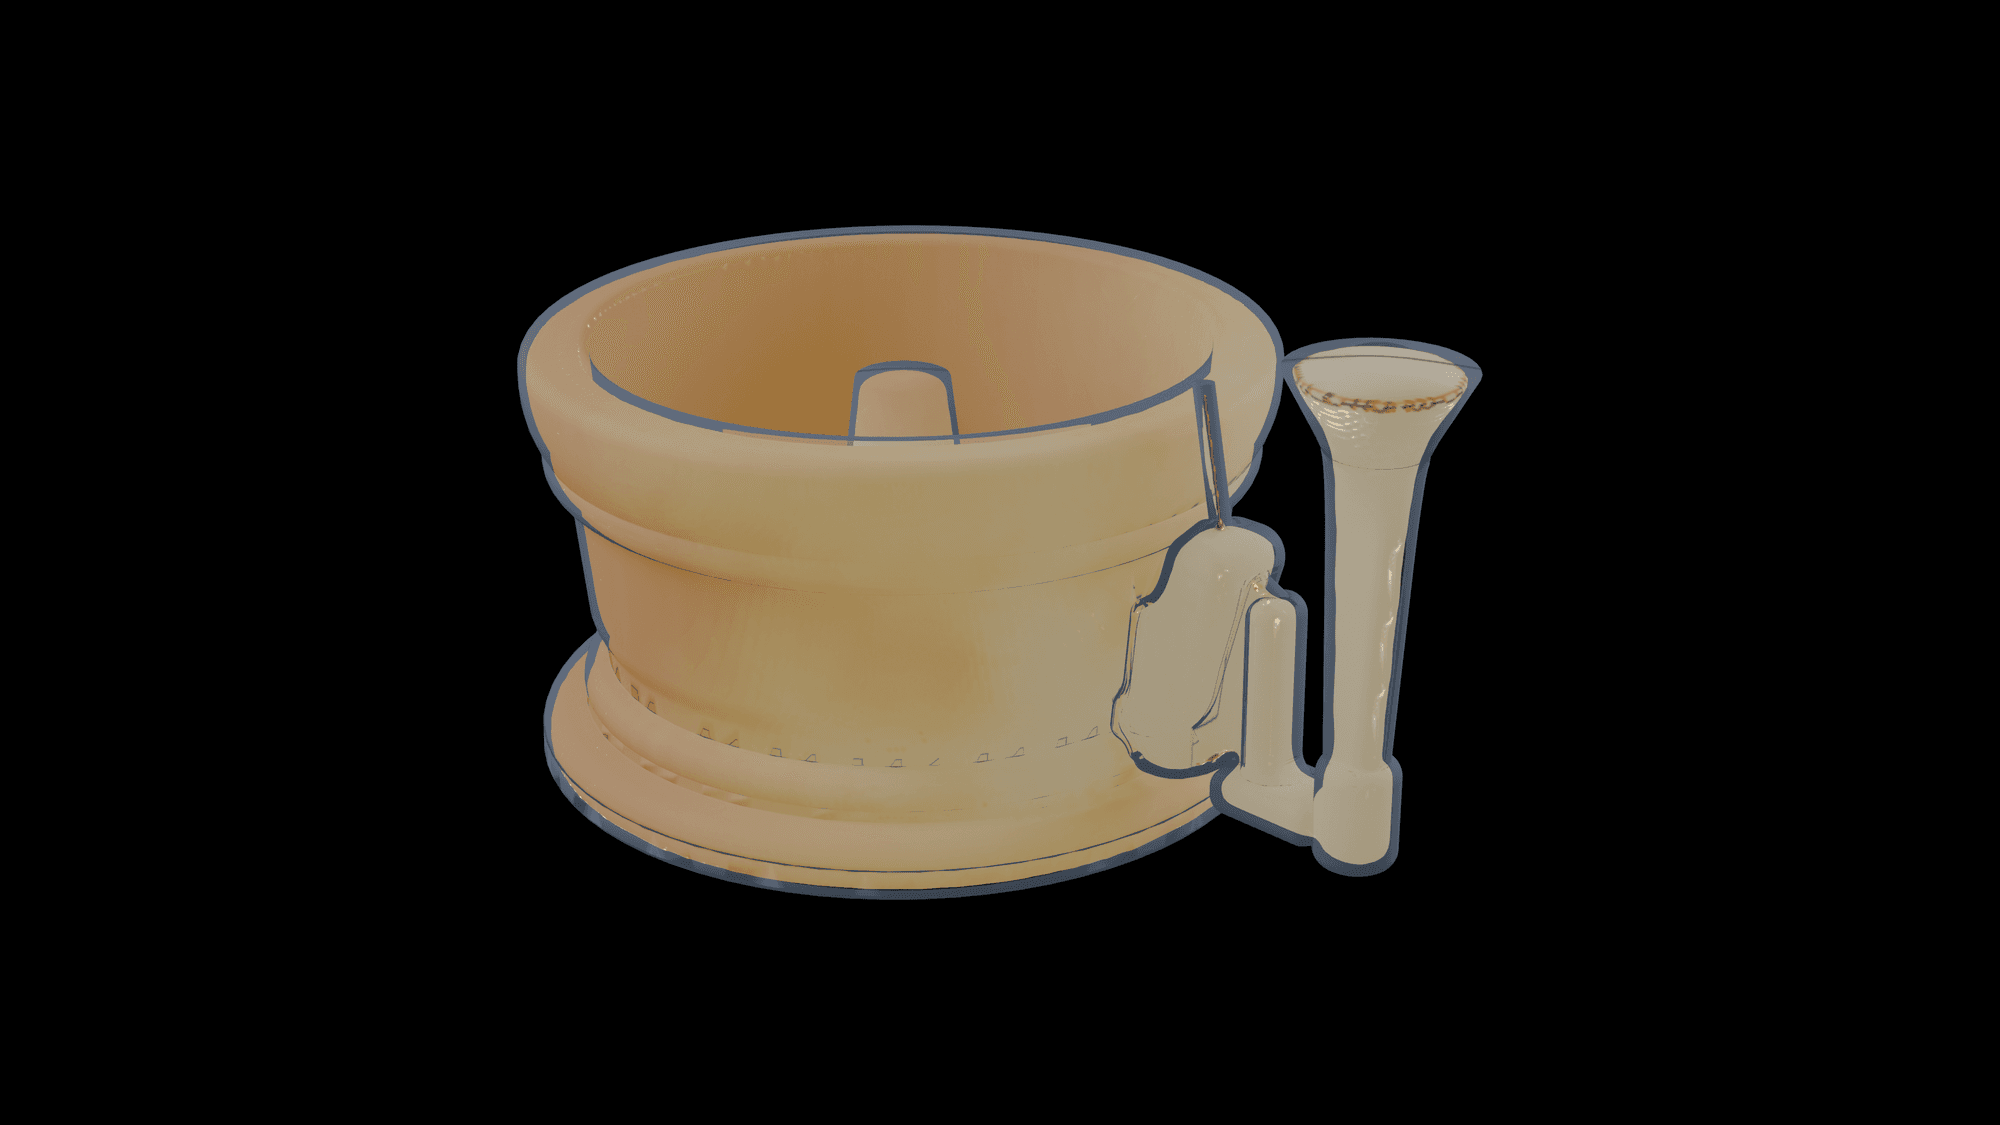
轮毂铸件的充型与凝固,用的是客户自己的几何。一镜到底:两个阶段热耦合,凝固从充型结束时的温度场接着算。
轮毂铸件,AlSi7Mg —— 充型到凝固,按温度上色。中心冒口下方最后那点亮色,就是铸件最后凝固的部位。
GPU 性能
给数字,不给口号
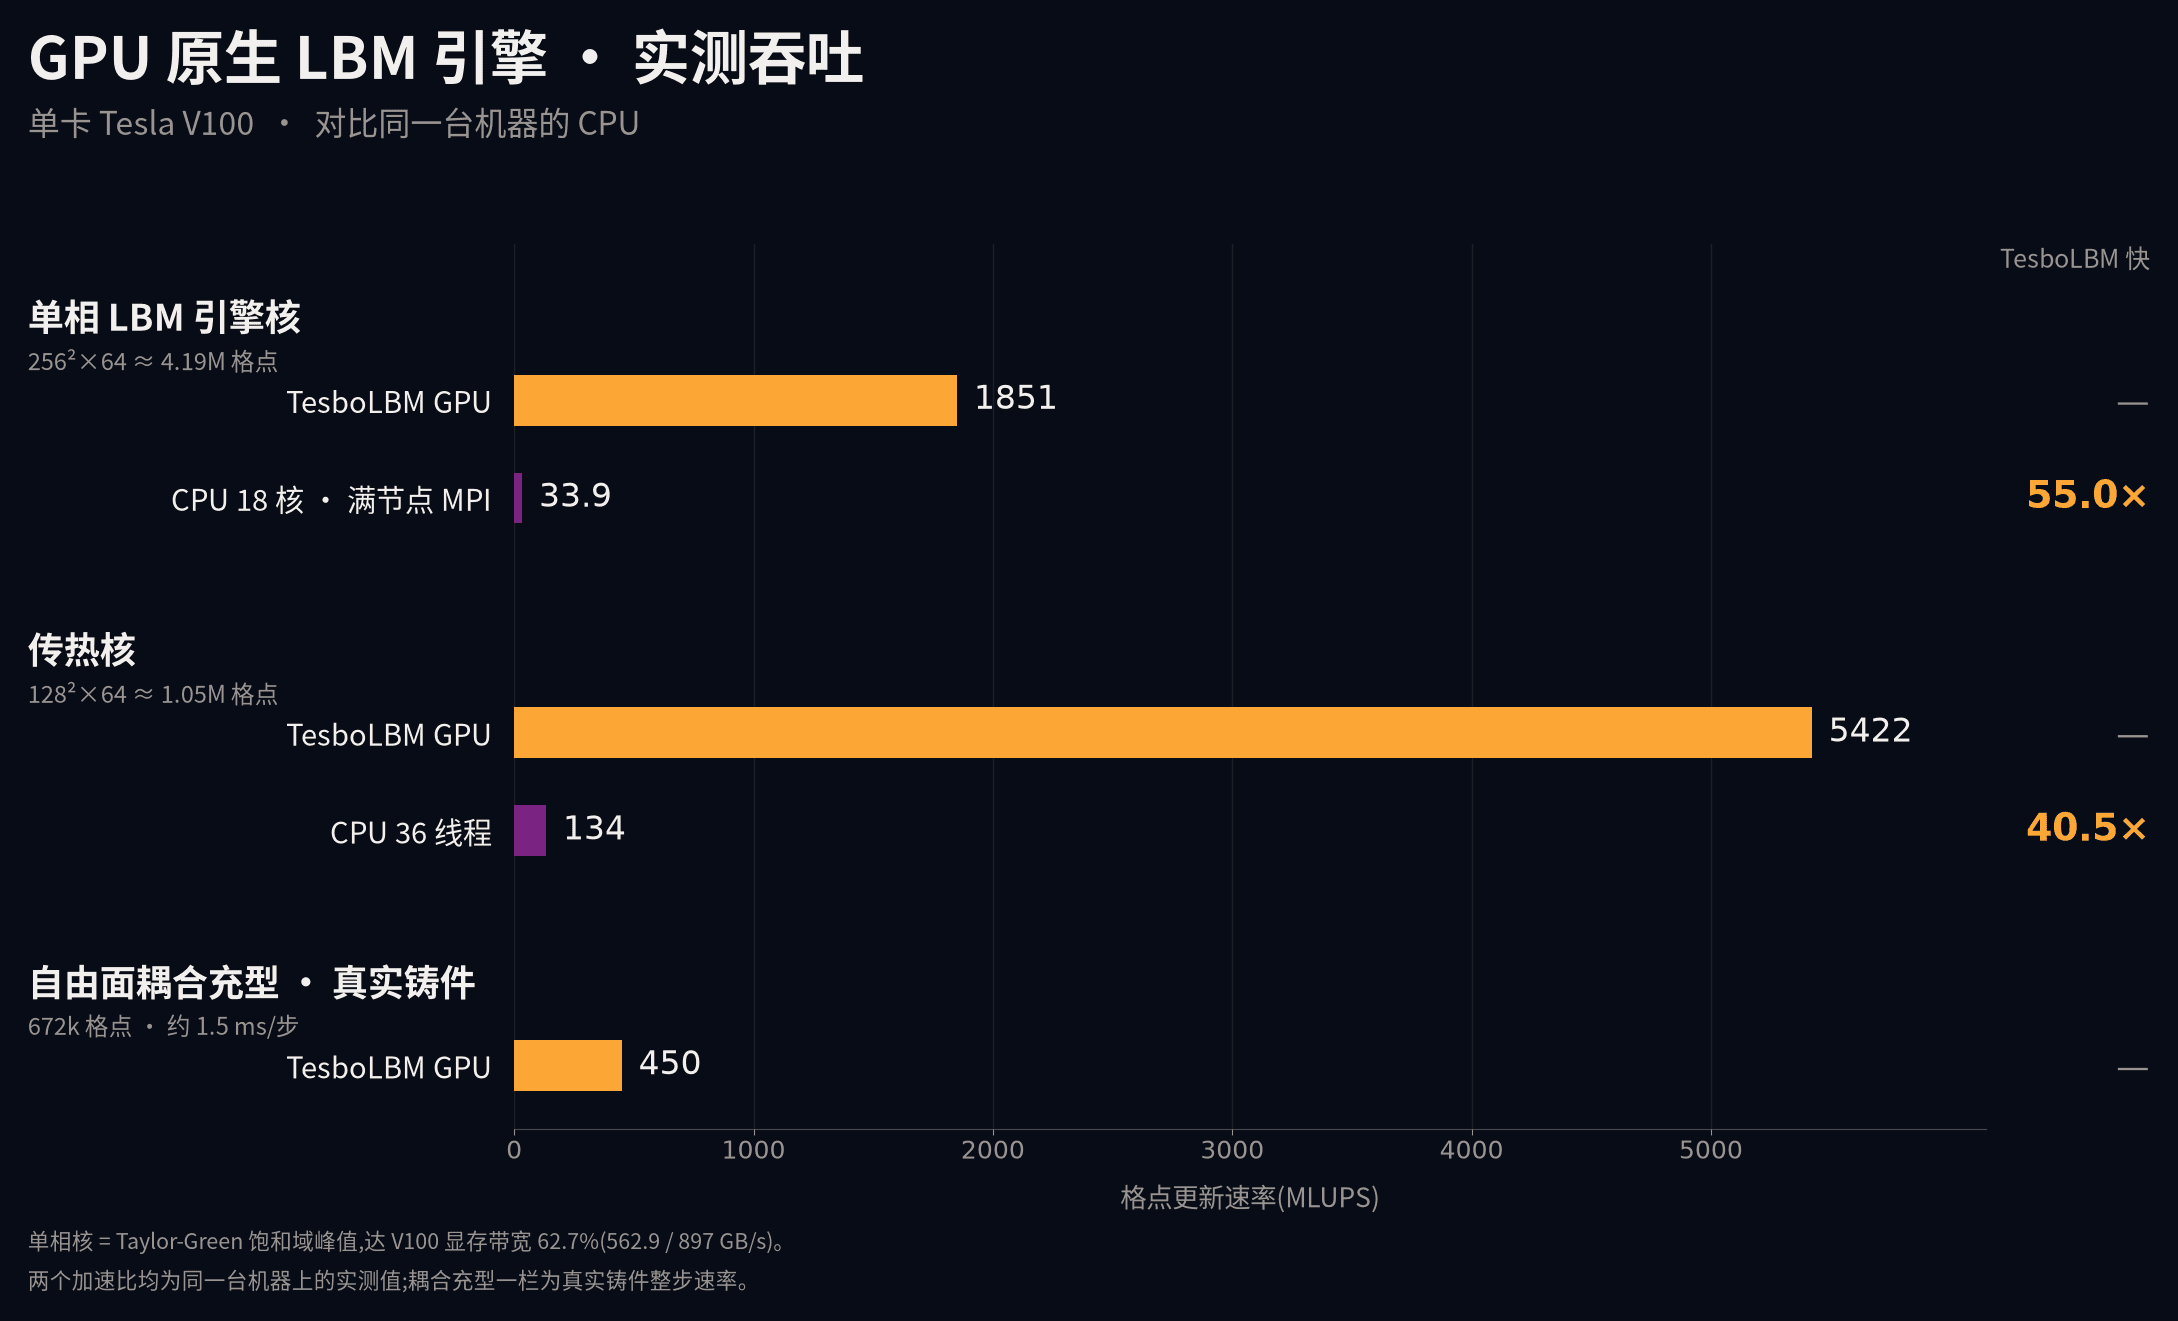
下面每个数都是在同一台机器上实测的:一块 Tesla V100 对同机的 CPU,跑同一个核。没有缩放,没有外推。
- 0×
单相 LBM 引擎核
单卡 V100 上 1851 MLUPS —— 达到该卡显存带宽的 62.7% —— 对同机 18 个 CPU 物理核全开的 33.9 MLUPS。网格 256² × 64,约 419 万格。
- 0.0×
传热核
5422 MLUPS 对 36 线程 CPU 的 134 MLUPS,两侧跑的是同一套算术。网格 128² × 64,约 105 万格。
- 0.0%
显存带宽利用率
单相核在 V100 上跑到 562.9 / 897 GB/s。格子玻尔兹曼是内存带宽受限的,这才是真正的天花板。
差距从哪来
来自带宽,不是主频。格子玻尔兹曼是内存带宽受限的,几个核就把一个 CPU 插槽的带宽吃满:同一台机器上,从 1 核到 18 核只快 8.3 倍(4.1 → 33.9 MLUPS,并行效率 45%)。而 V100 上跑到了该卡显存带宽的 62.7%。所以靠加 CPU 核心补不上这个差距。
1851 MLUPS 是单相核在满域下的峰值。真实铸件上的自由界面耦合充型约为 450 MLUPS 有效值(67.2 万格约 1.5 ms/步),因为每步要多带若干场、多走几遍。实际吞吐取决于铸件、网格与硬件。
能力
TesboLBM 能做什么
工艺
- 充型:LBM 自由表面追踪、亚格子湍流、自适应时间步
- 传热与凝固:潜热、界面热阻、多种固体材料
- 充型接凝固,温度场热连续
- 重力砂型铸造
- 低压铸造
物理模型
- 型腔背压与排气,按实体区分透气能力(排气道、冒口、冷铁、砂芯)
- 自然对流:浮力 + 糊状区阻力
- 真实固相率曲线 fs(T),可导入合金相图数据
- 界面换热系数(IHTC)由实测冷却曲线反推标定
- 仿真与实测对比工具,给误差与相关性指标
- 多组分合金物性数据接入
缺陷预测
- 缩松,Niyama 分级
- 热裂倾向
- 二次枝晶间距(SDAS)
平台与工作流
- CUDA GPU 后端
- CPU 后端(MPI 区域分解)
- 单机多卡,结果与单卡完全一致
- 自带命令行网格生成(充型网格与传热网格)
- 传热网格自适应加密
- 运行前配置静态校验
- 更细网格下的数值稳定性增强
核心技术特征
D3Q19 三维格子。速度与精度,同时到位。
MRT 多松弛碰撞。高雷诺数、强湍流之下,依然稳定。
LES Smagorinsky 亚格子模型。湍流的细微结构,尽在其中。
瞬态自由表面追踪。飞溅与卷气,如实呈现。
密度、热容、导热率随温度而变,潜热一并计入。传热与凝固,一体求解。
IHTC 界面换热。铸件与砂型、金属型、冷铁、冒口之间的瞬态热交换,逐一刻画。
控制方程
带外力项的 MRT 玻尔兹曼演化方程
碰撞在矩空间中逐项松弛,重力项一并纳入。剪切黏度与体积黏度自此解耦,不再受 BGK 单一松弛时间所限。
LES 亚格子湍流黏度方程
湍流黏度由局部应变率的二阶不变量动态给出。亚格子耗散随流场而变,而非一个常数。
工业应用场景
重力砂型铸造
浇注系统、内浇口、多流道与型腔,一并解算。充型前沿、液流汇合、充型途中的温降,尽在预测之中。
高压与低压压铸
在型壁、冷铁与砂芯之间,捕捉高速金属液的每一次转折。卷气、死角、卷渣,以及浇冒口的补缩,皆可预见。
传热与凝固
物性随温度而变,潜热如实释放。预测凝固路径,看清冷却水道如何改变凝固节奏,把缩孔止于设计阶段。