真实求解器输出
不是渲染,是解。
每一帧都由 TesboFlow 在 GPU 上算出——几何、湍流尾迹、涡结构。这就是求解器真正产出的结果。
性能
已经这么快。这块硬件。现在。
四张收据,不是目标。对单核、对 18 核、自研 AMG 对 NVIDIA AmgX、以及一张卡装不下的网格。
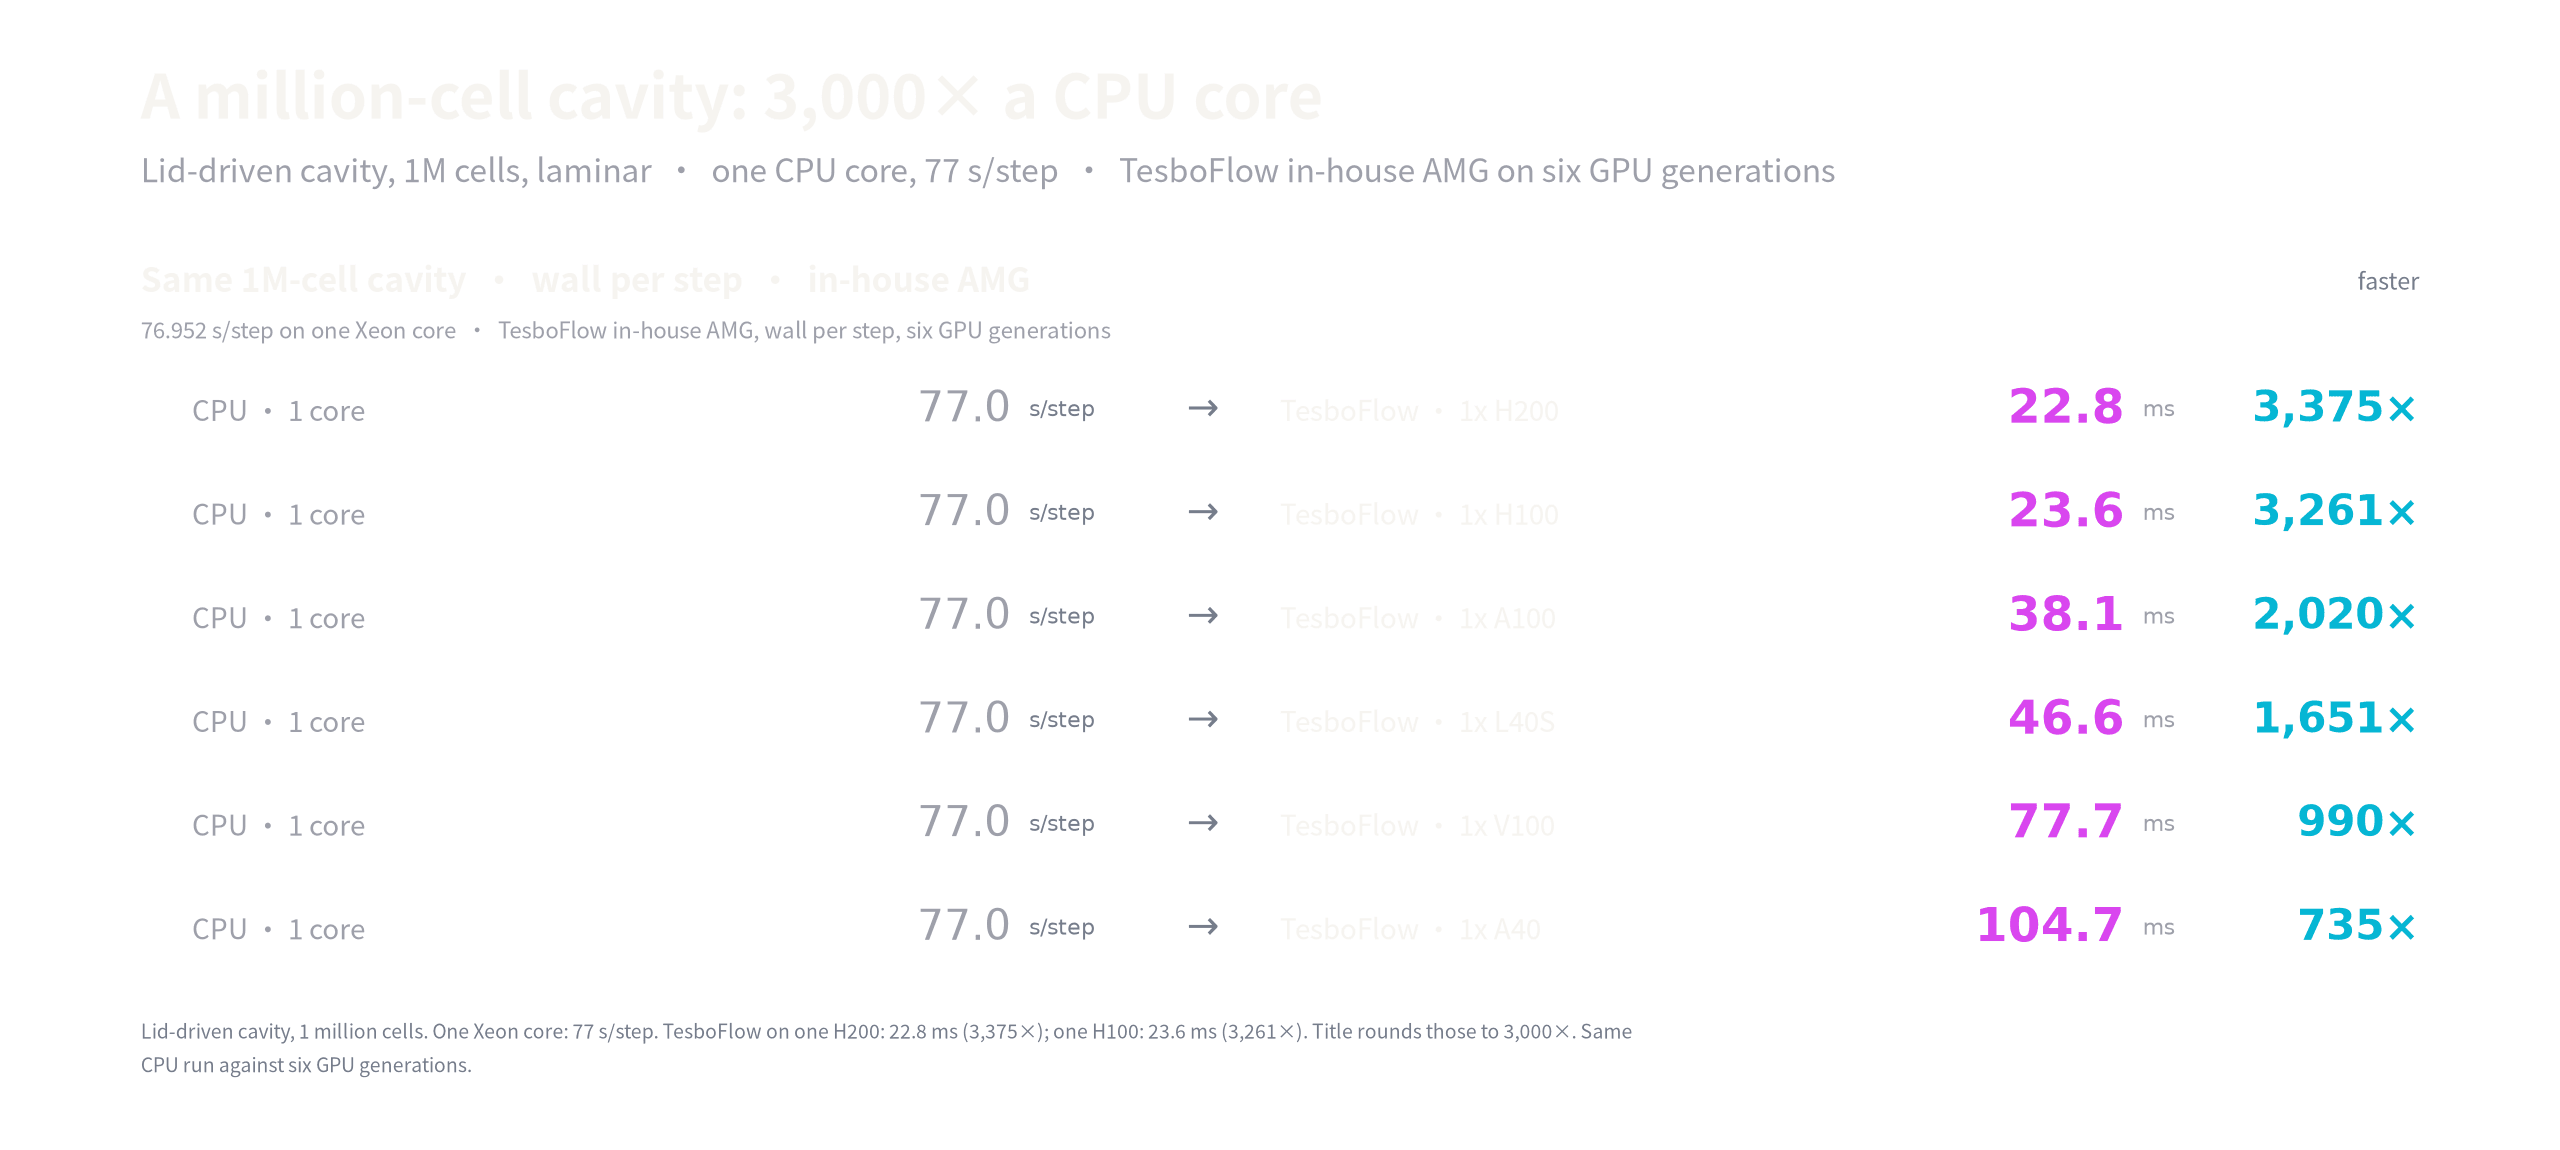
- 3,000×
对单核 CPU
百万胞方腔。单核 CPU 77 s/步。TesboFlow 一张 H200 22.8 ms。
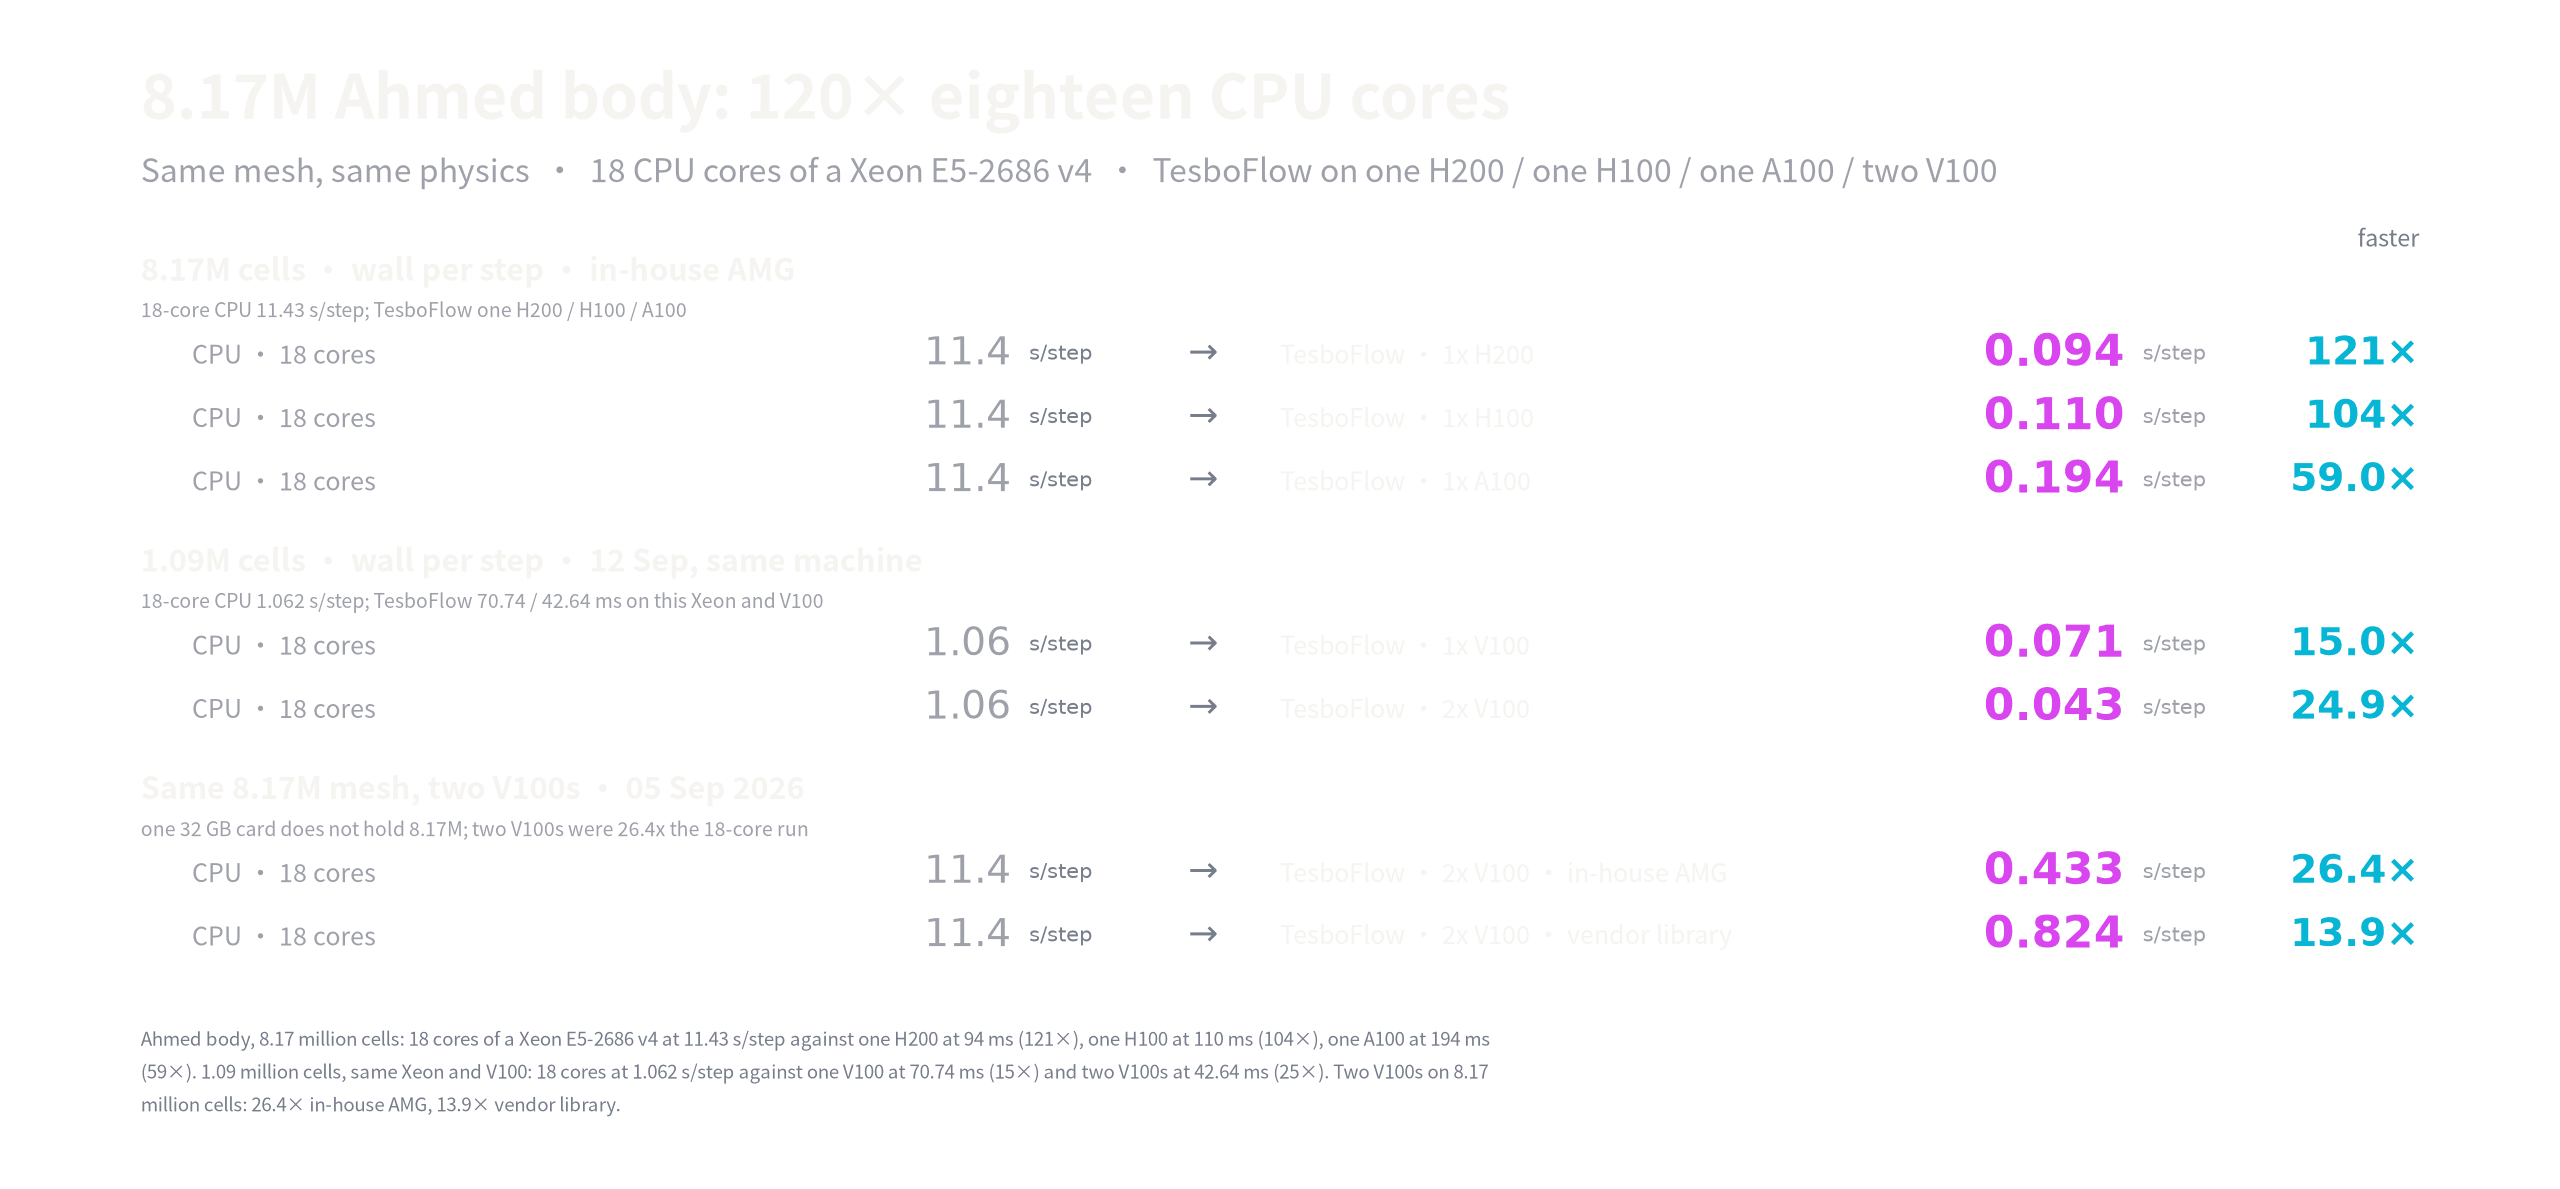
- 100×
对 18 核 CPU
817 万胞 Ahmed。18 核 CPU 11.4 s/步。TesboFlow 一张 H200 94 ms。
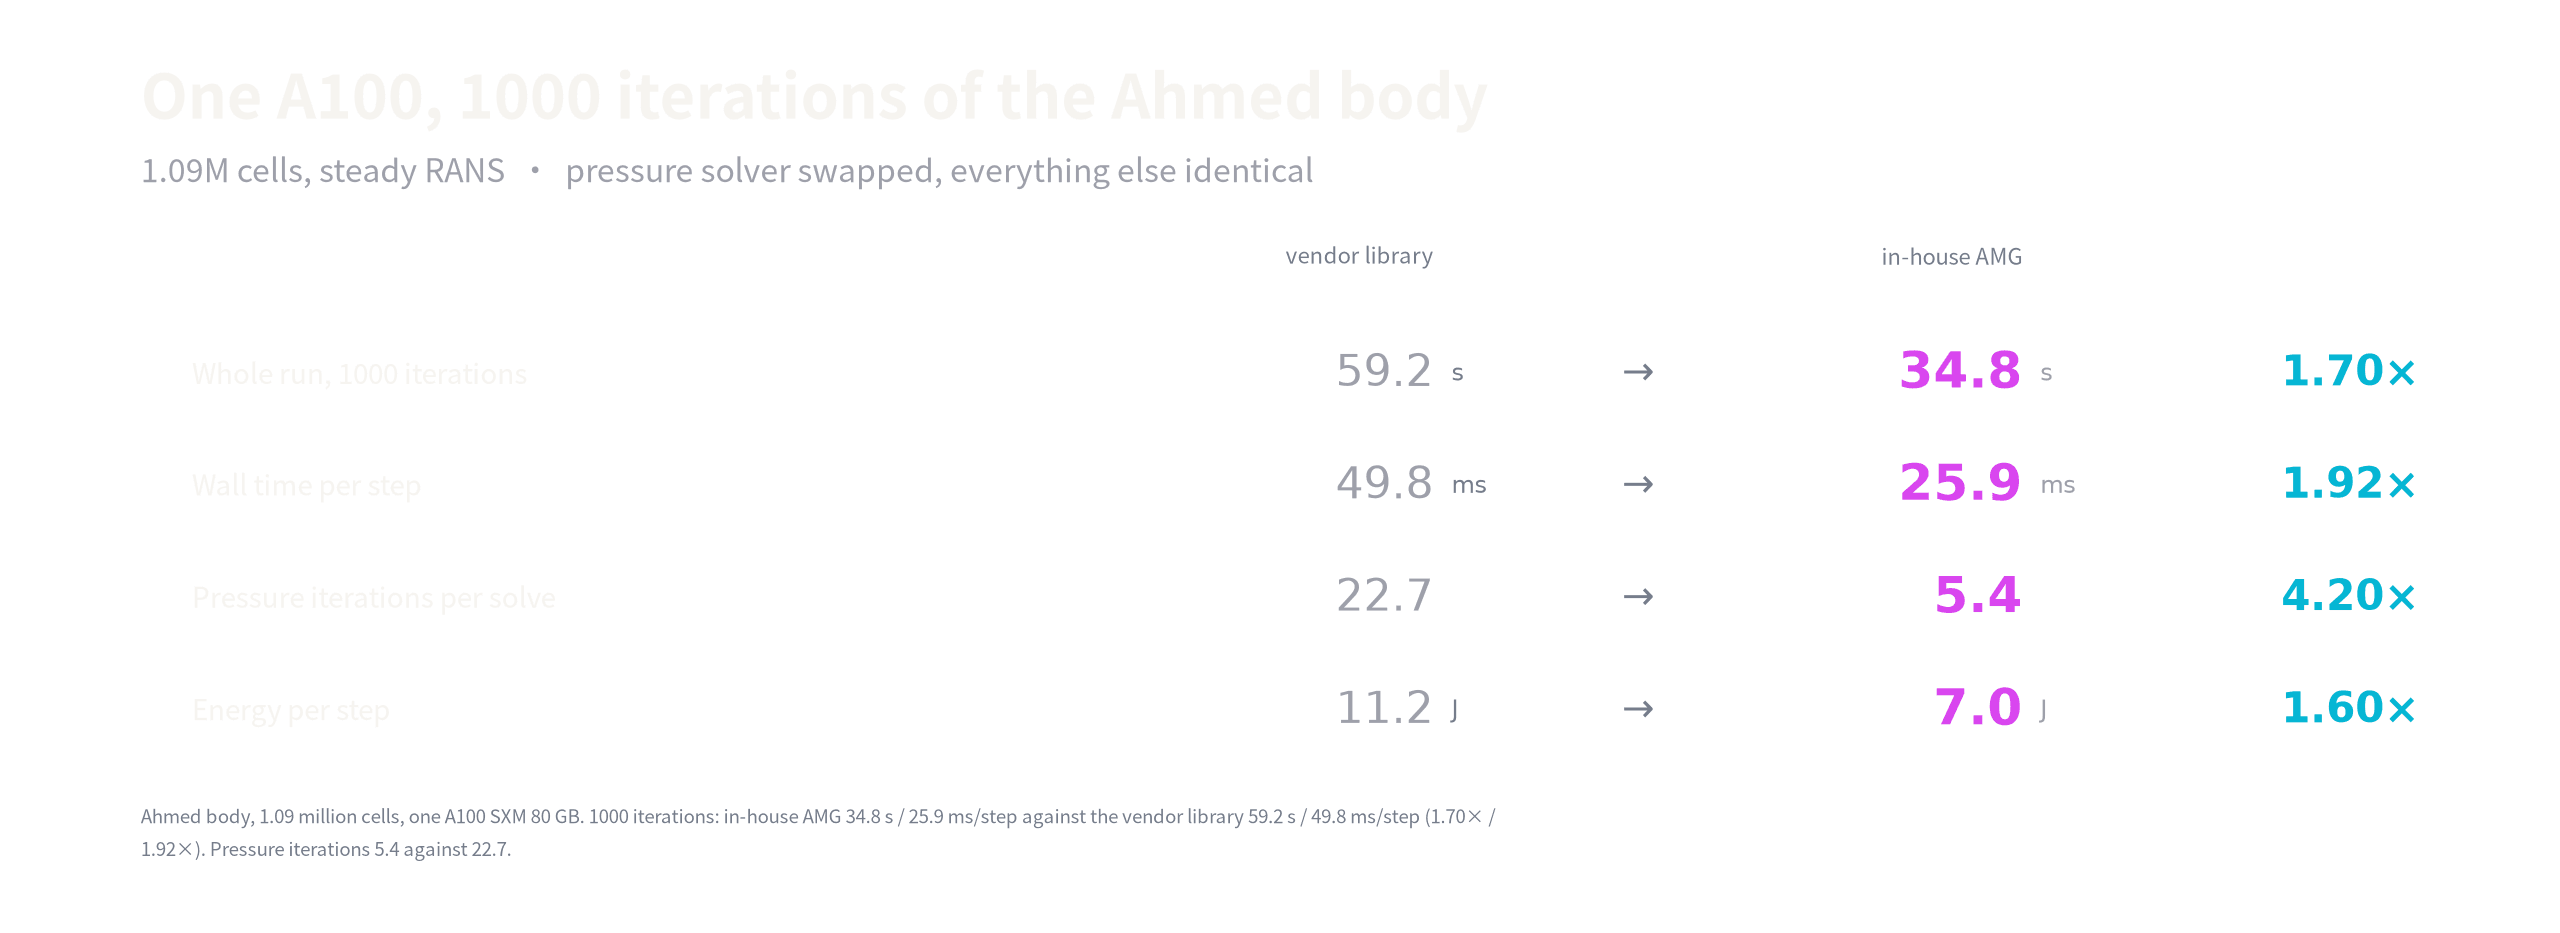
- ~2×
对 NVIDIA AmgX
自研 AMG。Ahmed,一张 A100,一千步:35 秒对 59 秒,7 焦耳对 11 焦耳。
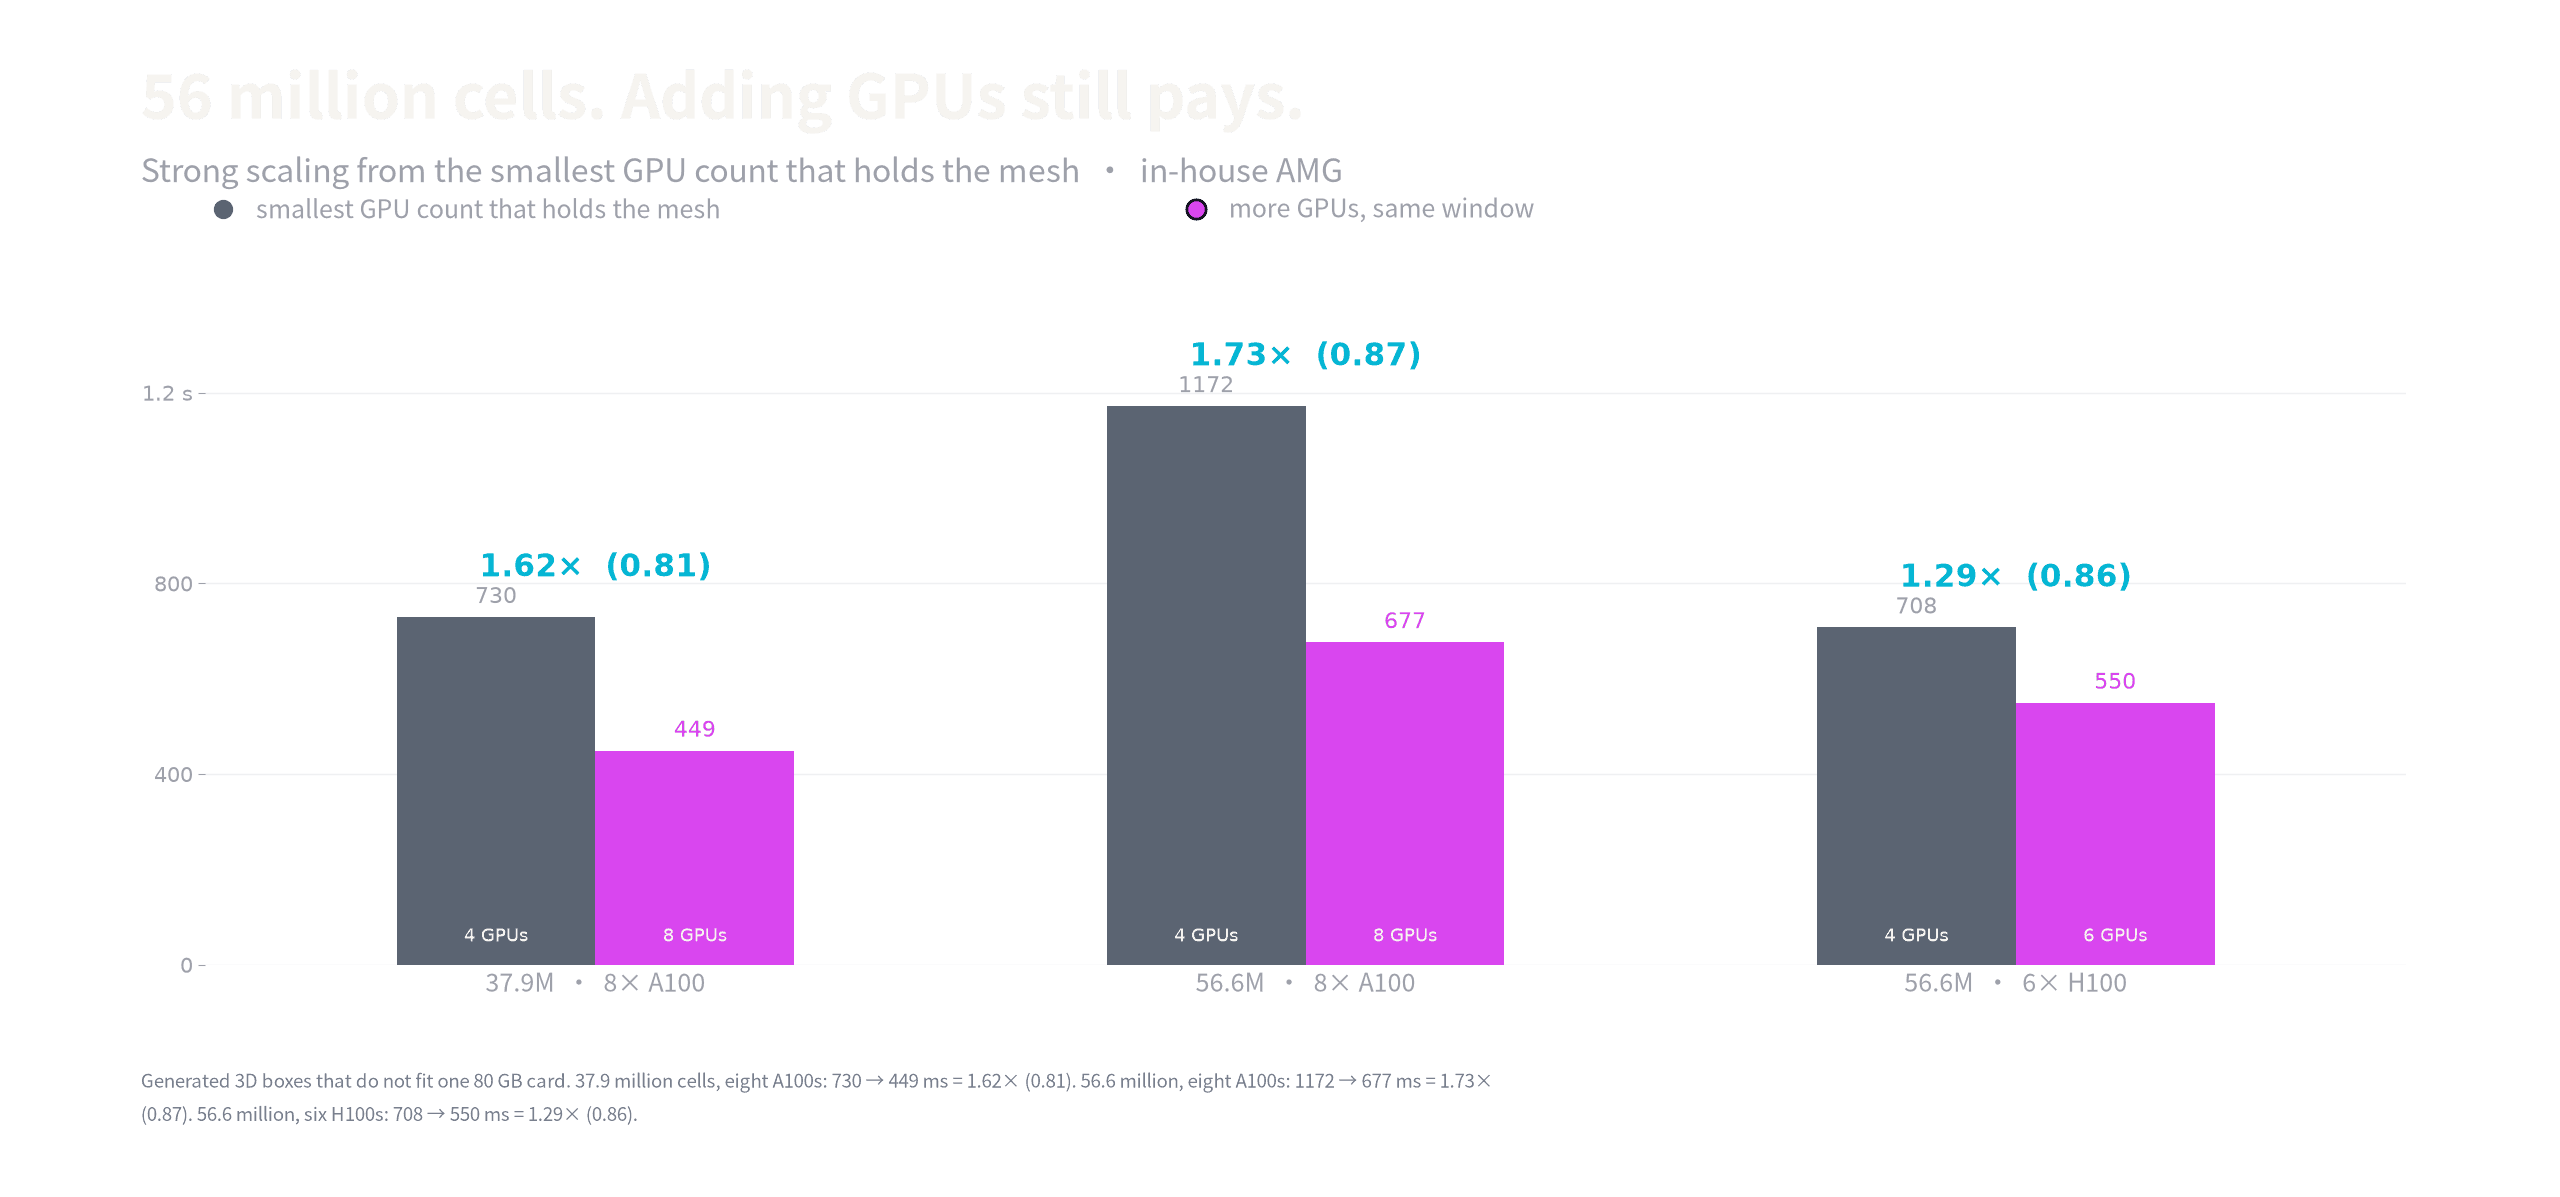
- 1 秒
1 亿网格,算一步
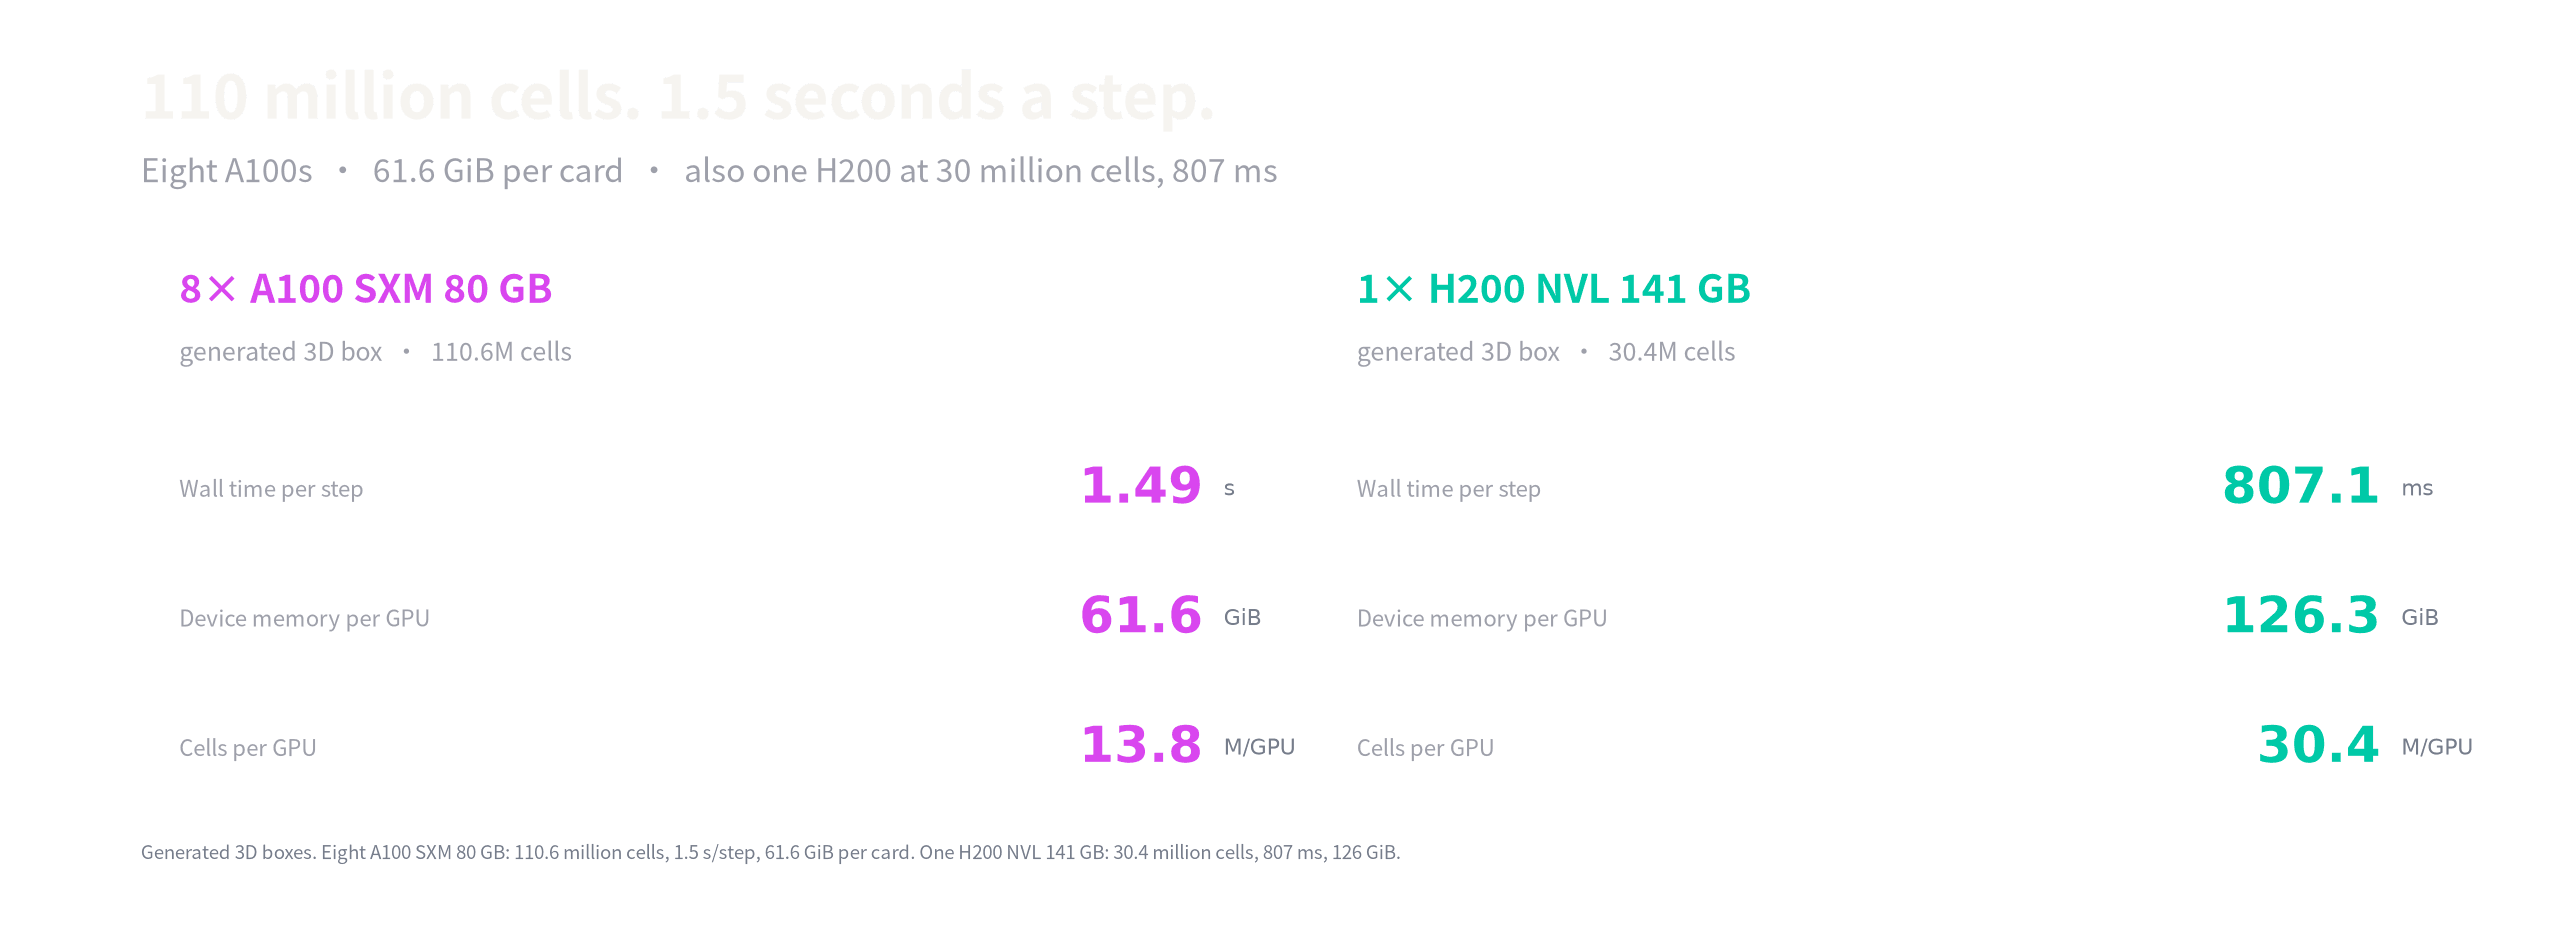
1.1 亿胞,8 张 A100,每卡 61.6 GiB,每步 1.5 秒。1 亿网格,算一步,花一秒。
1 亿网格,算一步,花一秒。
实测:1.1 亿胞,八张 A100,每步 1.5 秒,每卡 61.6 GiB。一张 H200,126 GiB,装下 3040 万胞。
测的是什么
四组实测。百万胞方腔对单核。Ahmed 对 18 核。自研 AMG 对 NVIDIA AmgX。一张卡装不下的网格。八张 A100 上 1.1 亿胞,每卡 61.6 GiB,每步 1.5 秒。
同一份百万胞方腔,从 V100 跑到 H200。一个求解器,六代卡。
典型场景,不是合同。对 CPU 集群 100–1000× 仍是目标量级,不是上面这些实测。
求解器出图
我们真正跑过的算例
我们真正跑过的算例。卡片上是求解器出的画面,有静帧也有短片。
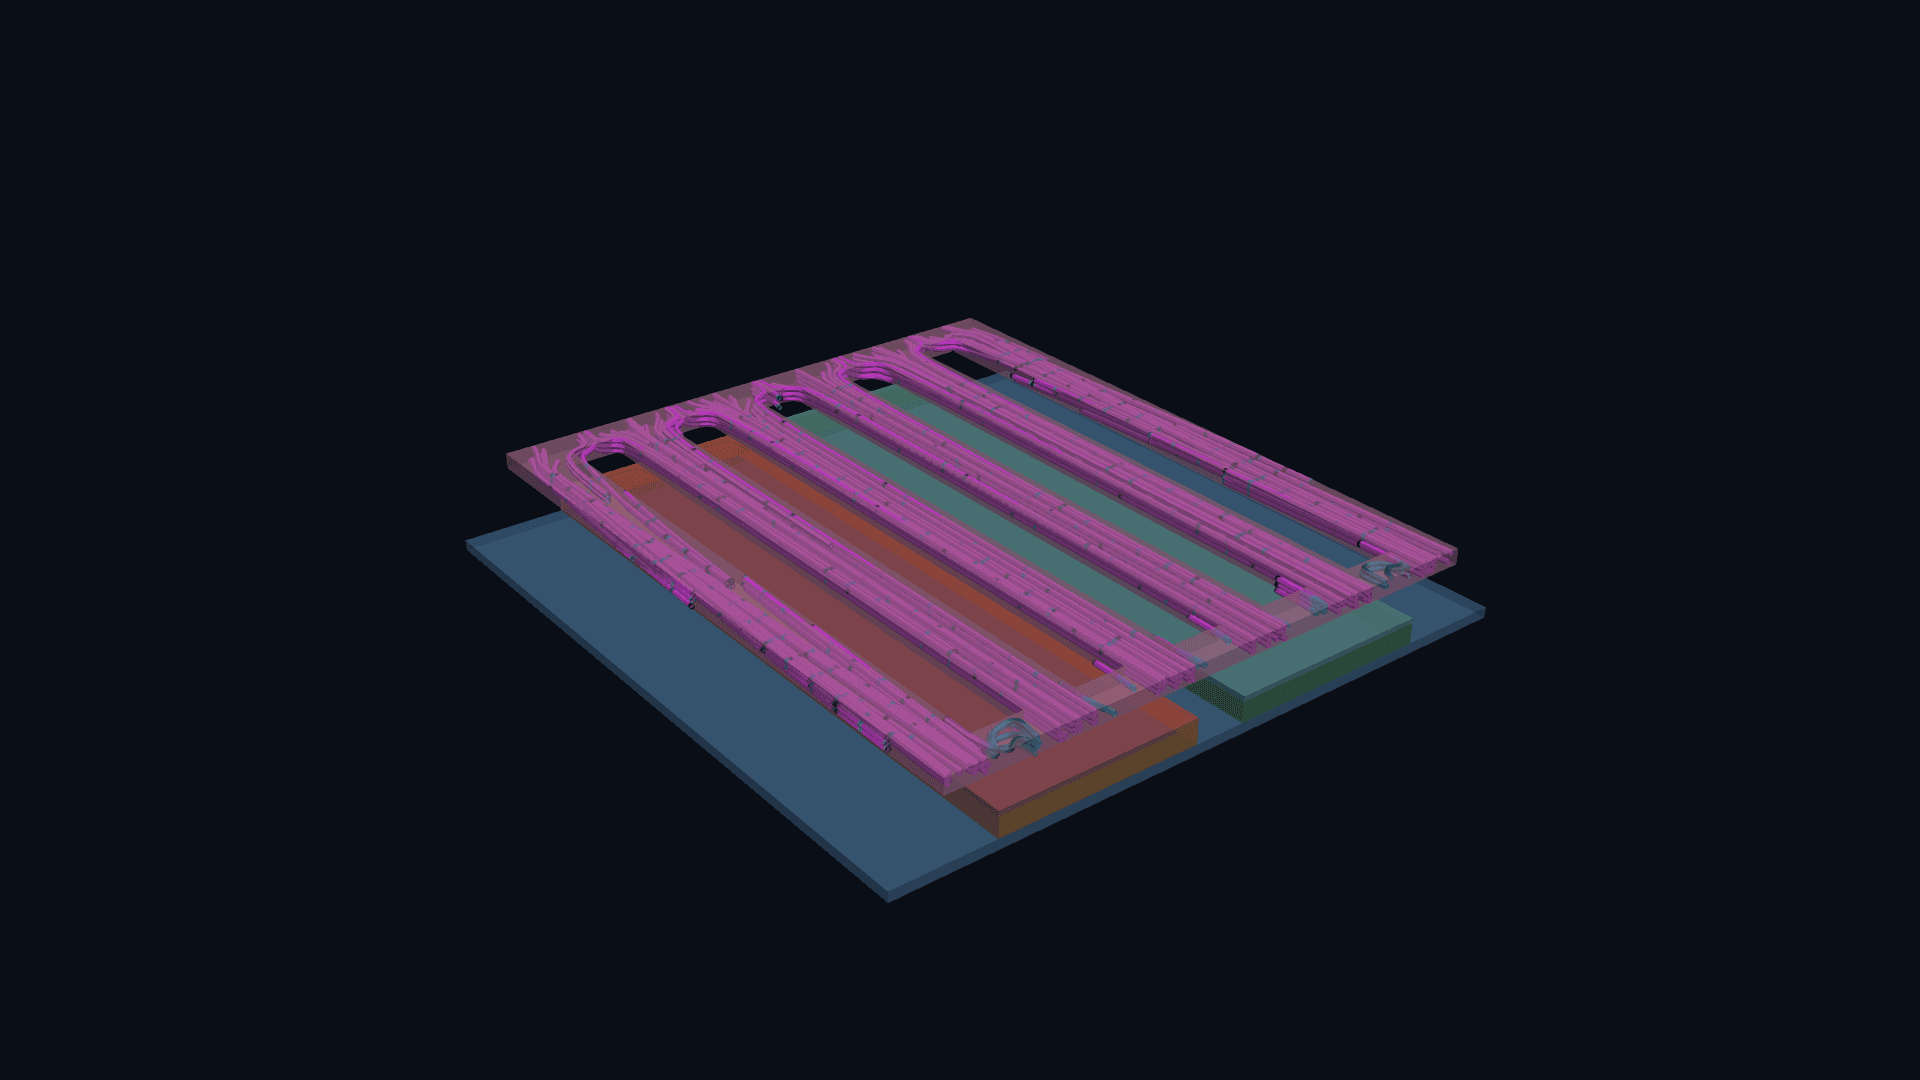
中介层冷板
流道和叠层一起做共轭传热。流体和固体一次求出。
CHT · 已支持
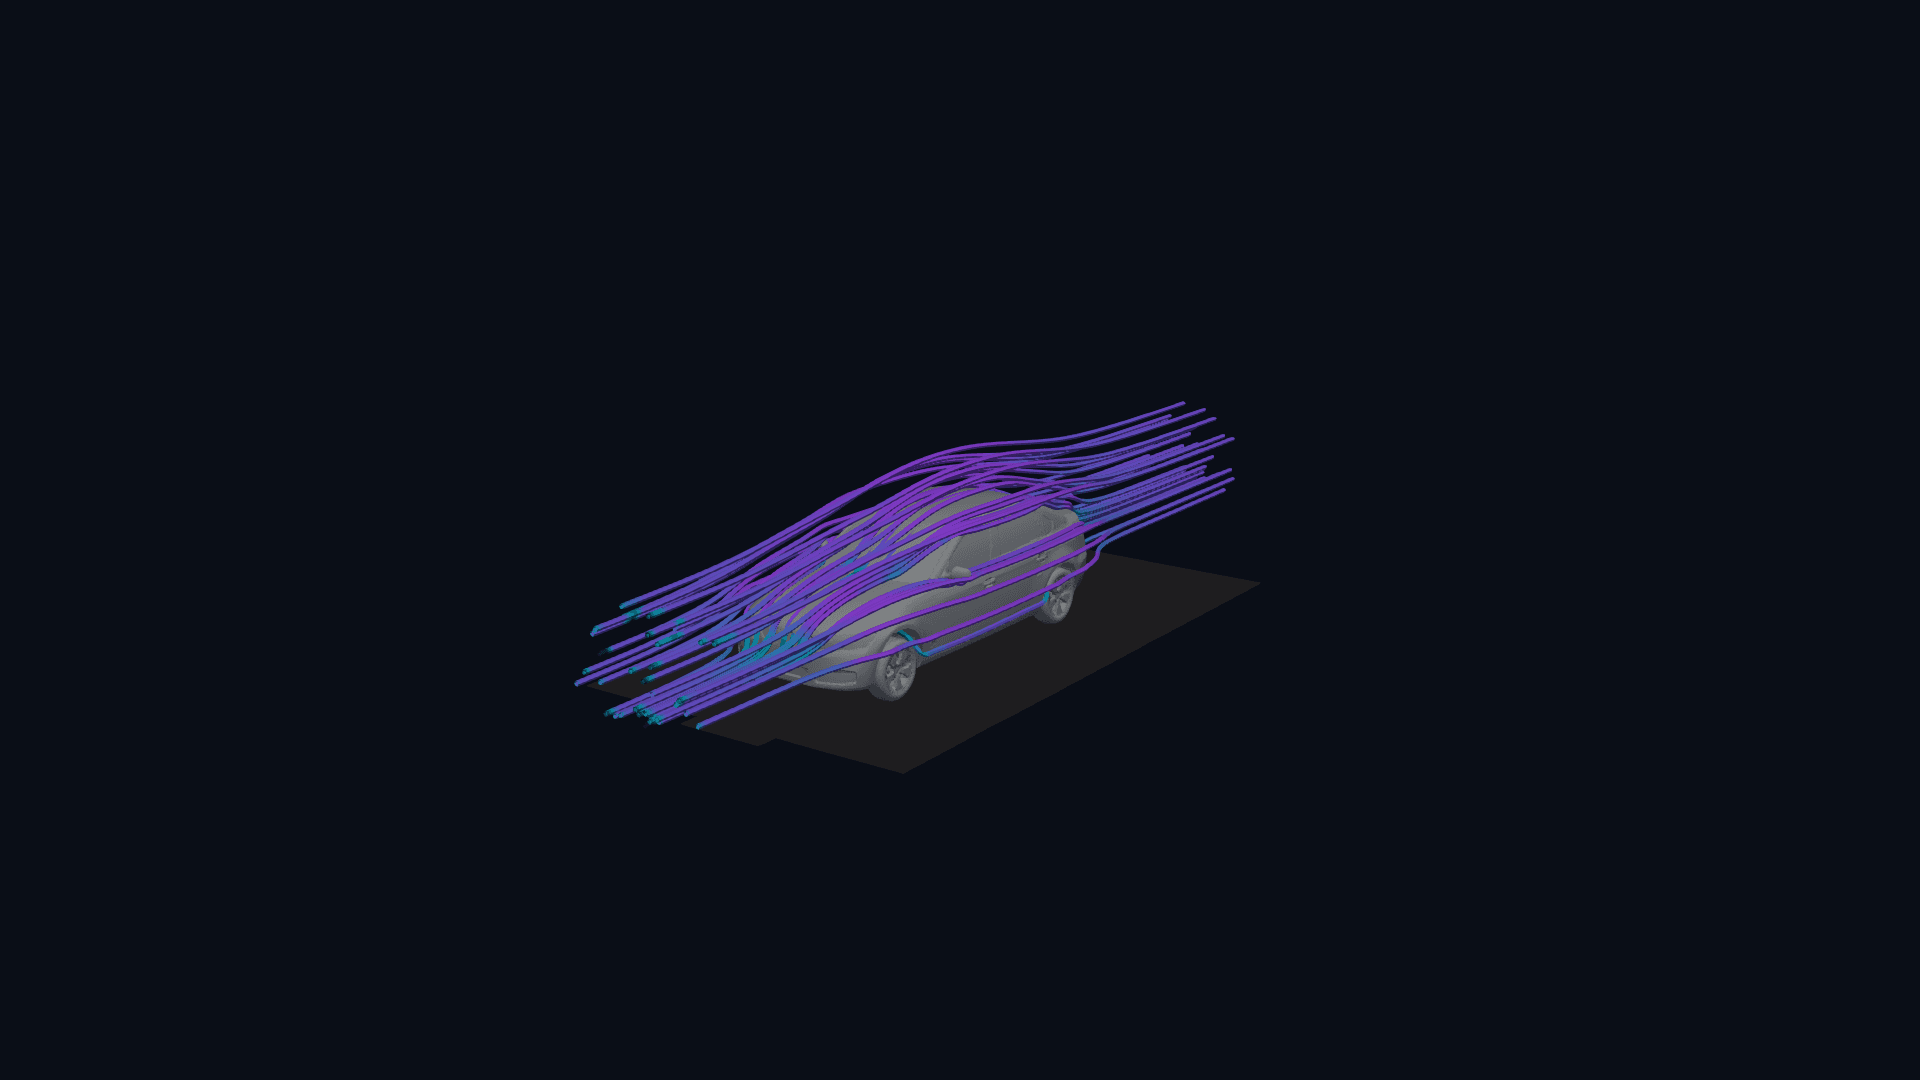
DrivAer
量产外形轿车外流。画面是尾迹,不是阻力系数。
外流 · 尾迹
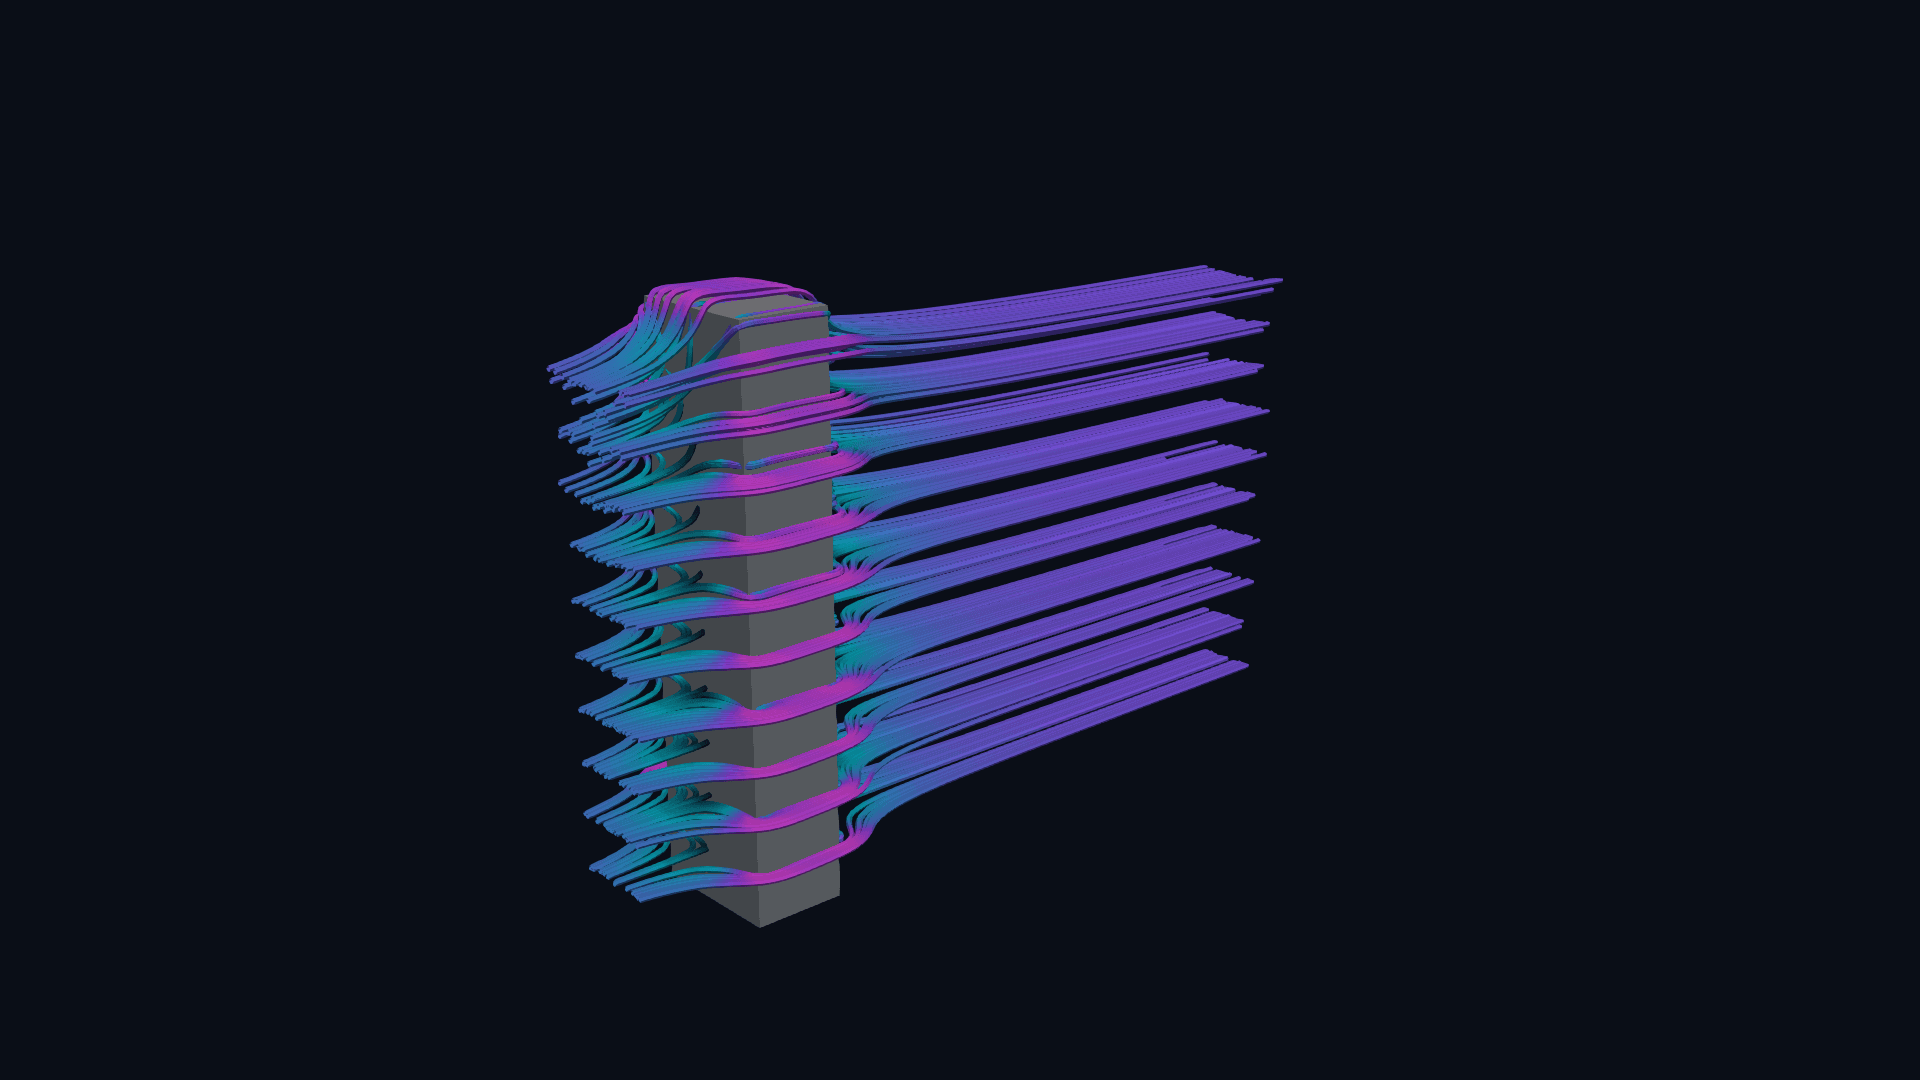
CAARC 高层建筑
大气边界层里的标准高层。侧面脱落,不是一张漂亮渲染。
标准 CAARC 棱柱
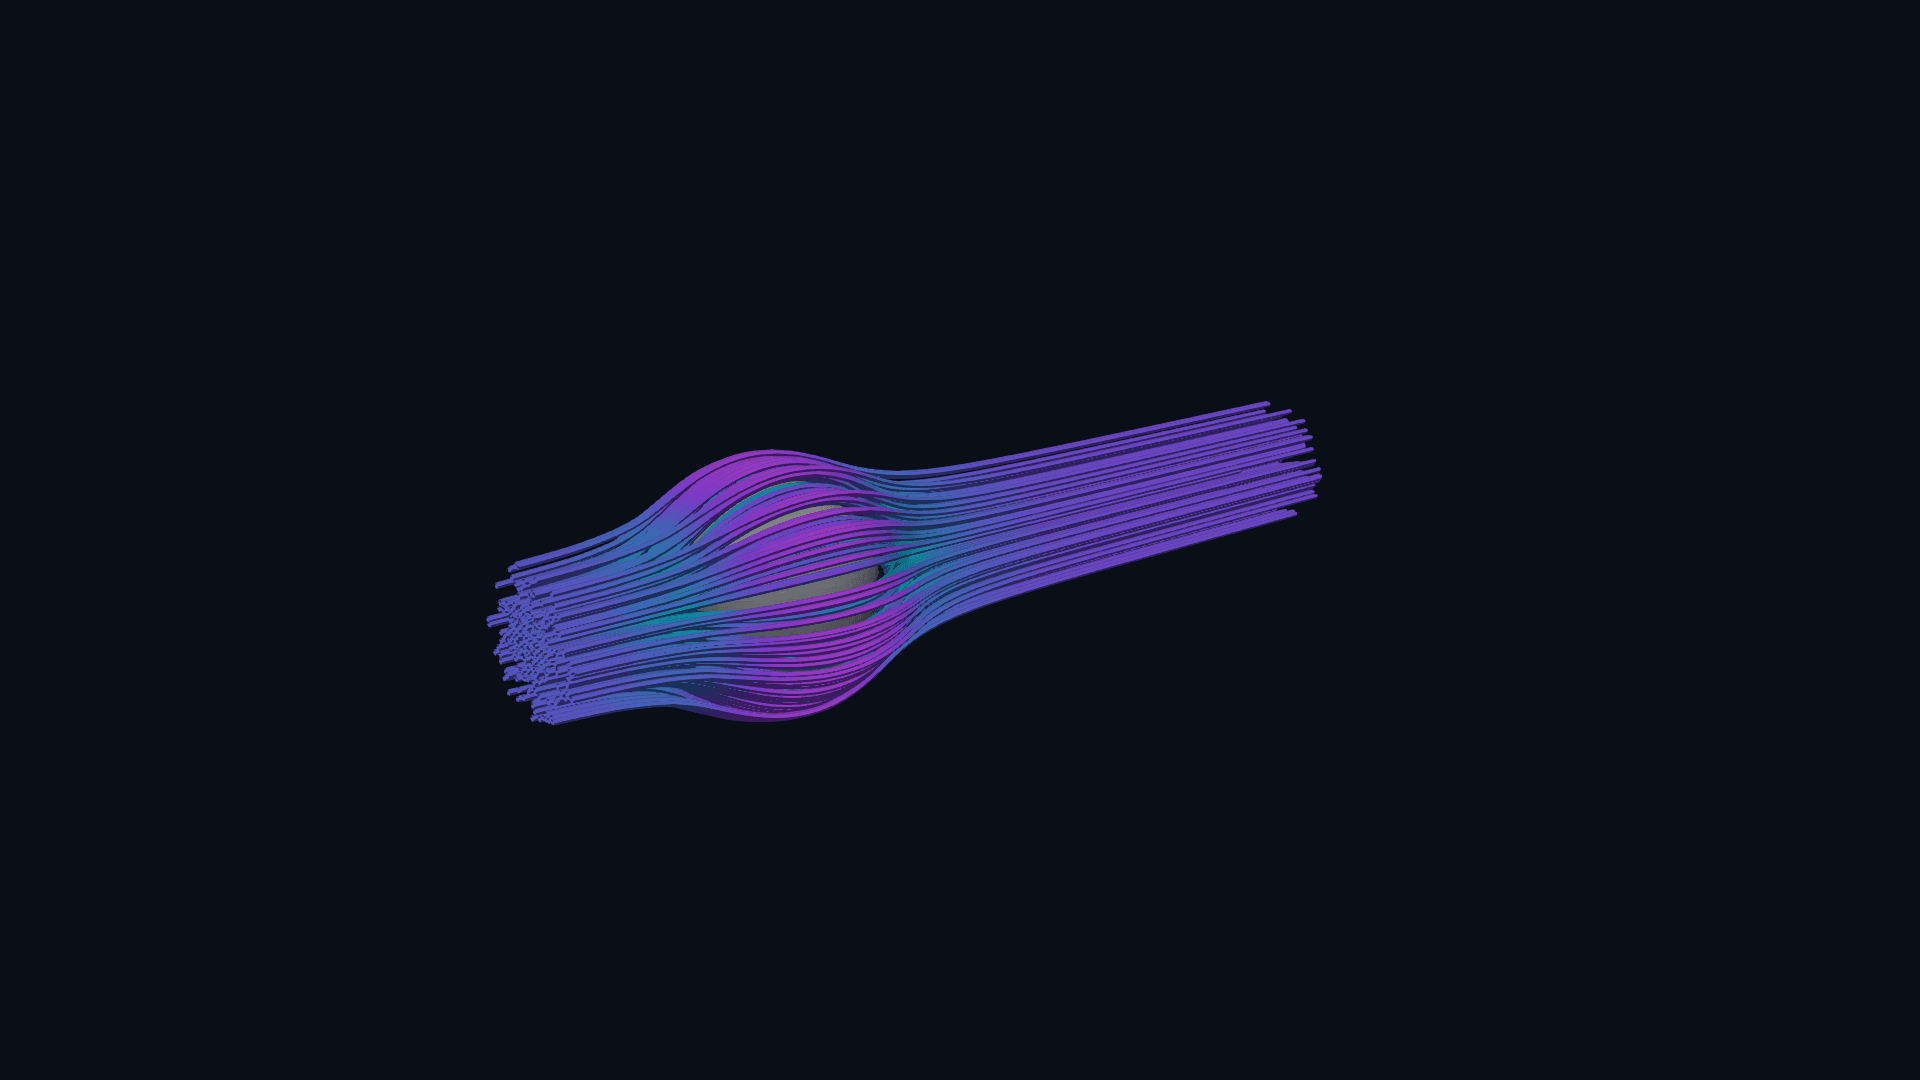
球体
人人都做过的钝体。流线绕过去,再往下游走。
标准外流
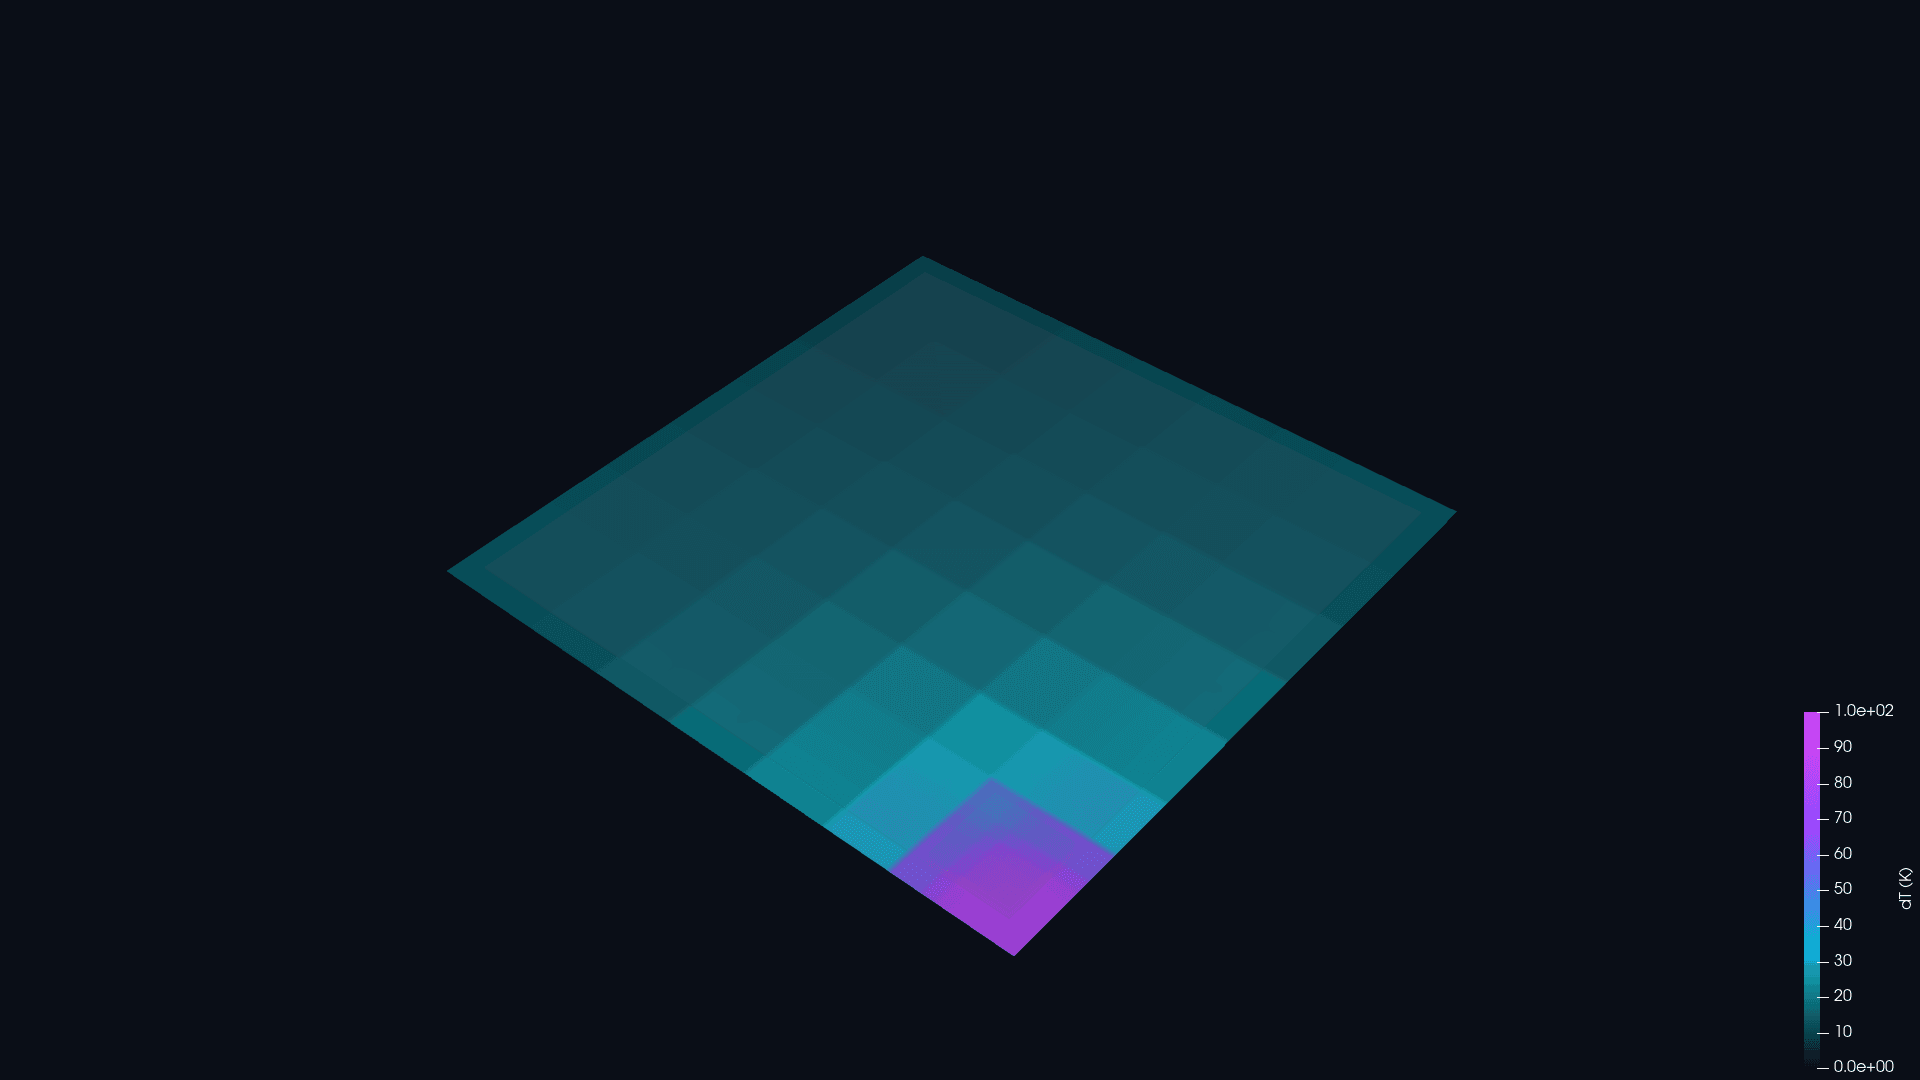
JEDEC PBGA
封装尺度的共轭传热。那个热角是加热器,不是贴图。
CHT · 封装级
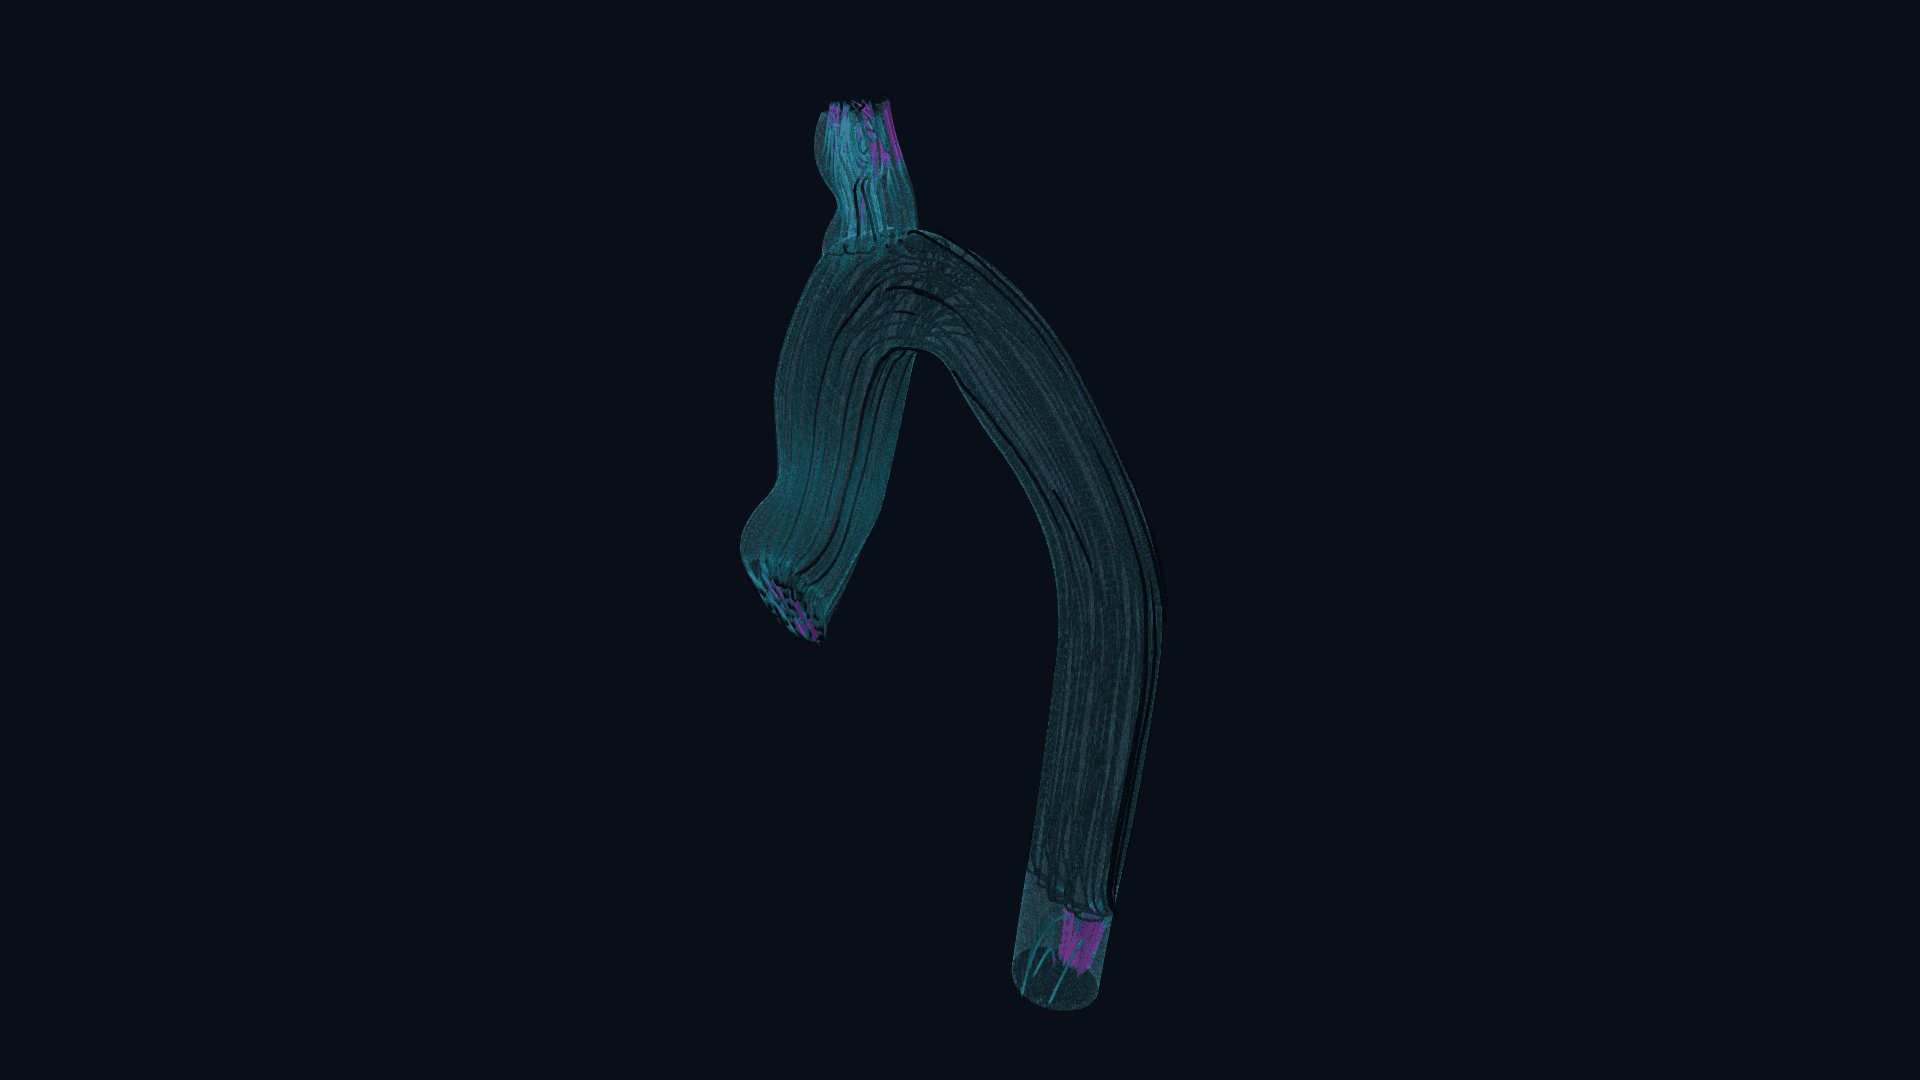
主动脉
患者几何,入口出口做了简化。是流场图,不是临床研究。
非临床
基准
三个数,一行写完
上面三组实测,一行写完。典型场景,不是合同。
| 算例 | 网格 | CPU 参照 | TesboFlow | 倍数 |
|---|---|---|---|---|
| 顶盖驱动方腔,层流 | 100 万胞 | CPU · 1 核 · 77.0 s/步 | 1× H200 · 22.8 ms/步 | 3,000× |
| Ahmed 25°,定常 RANS | 817 万胞 | CPU · 18 核 · 11.4 s/步 | 1× H200 · 94 ms/步 | 100× |
| 生成的三维盒子 | 1.1 亿胞 | — | 8× A100 · 1.5 s/步 | 一步一秒 |
典型场景,不是合同。算例与硬件见表。
验证体系
我们如何确认结果是对的
正确性由三条独立路径交叉确认:解析解与制造解、公开文献基准、与独立 CPU 求解器逐场对标。
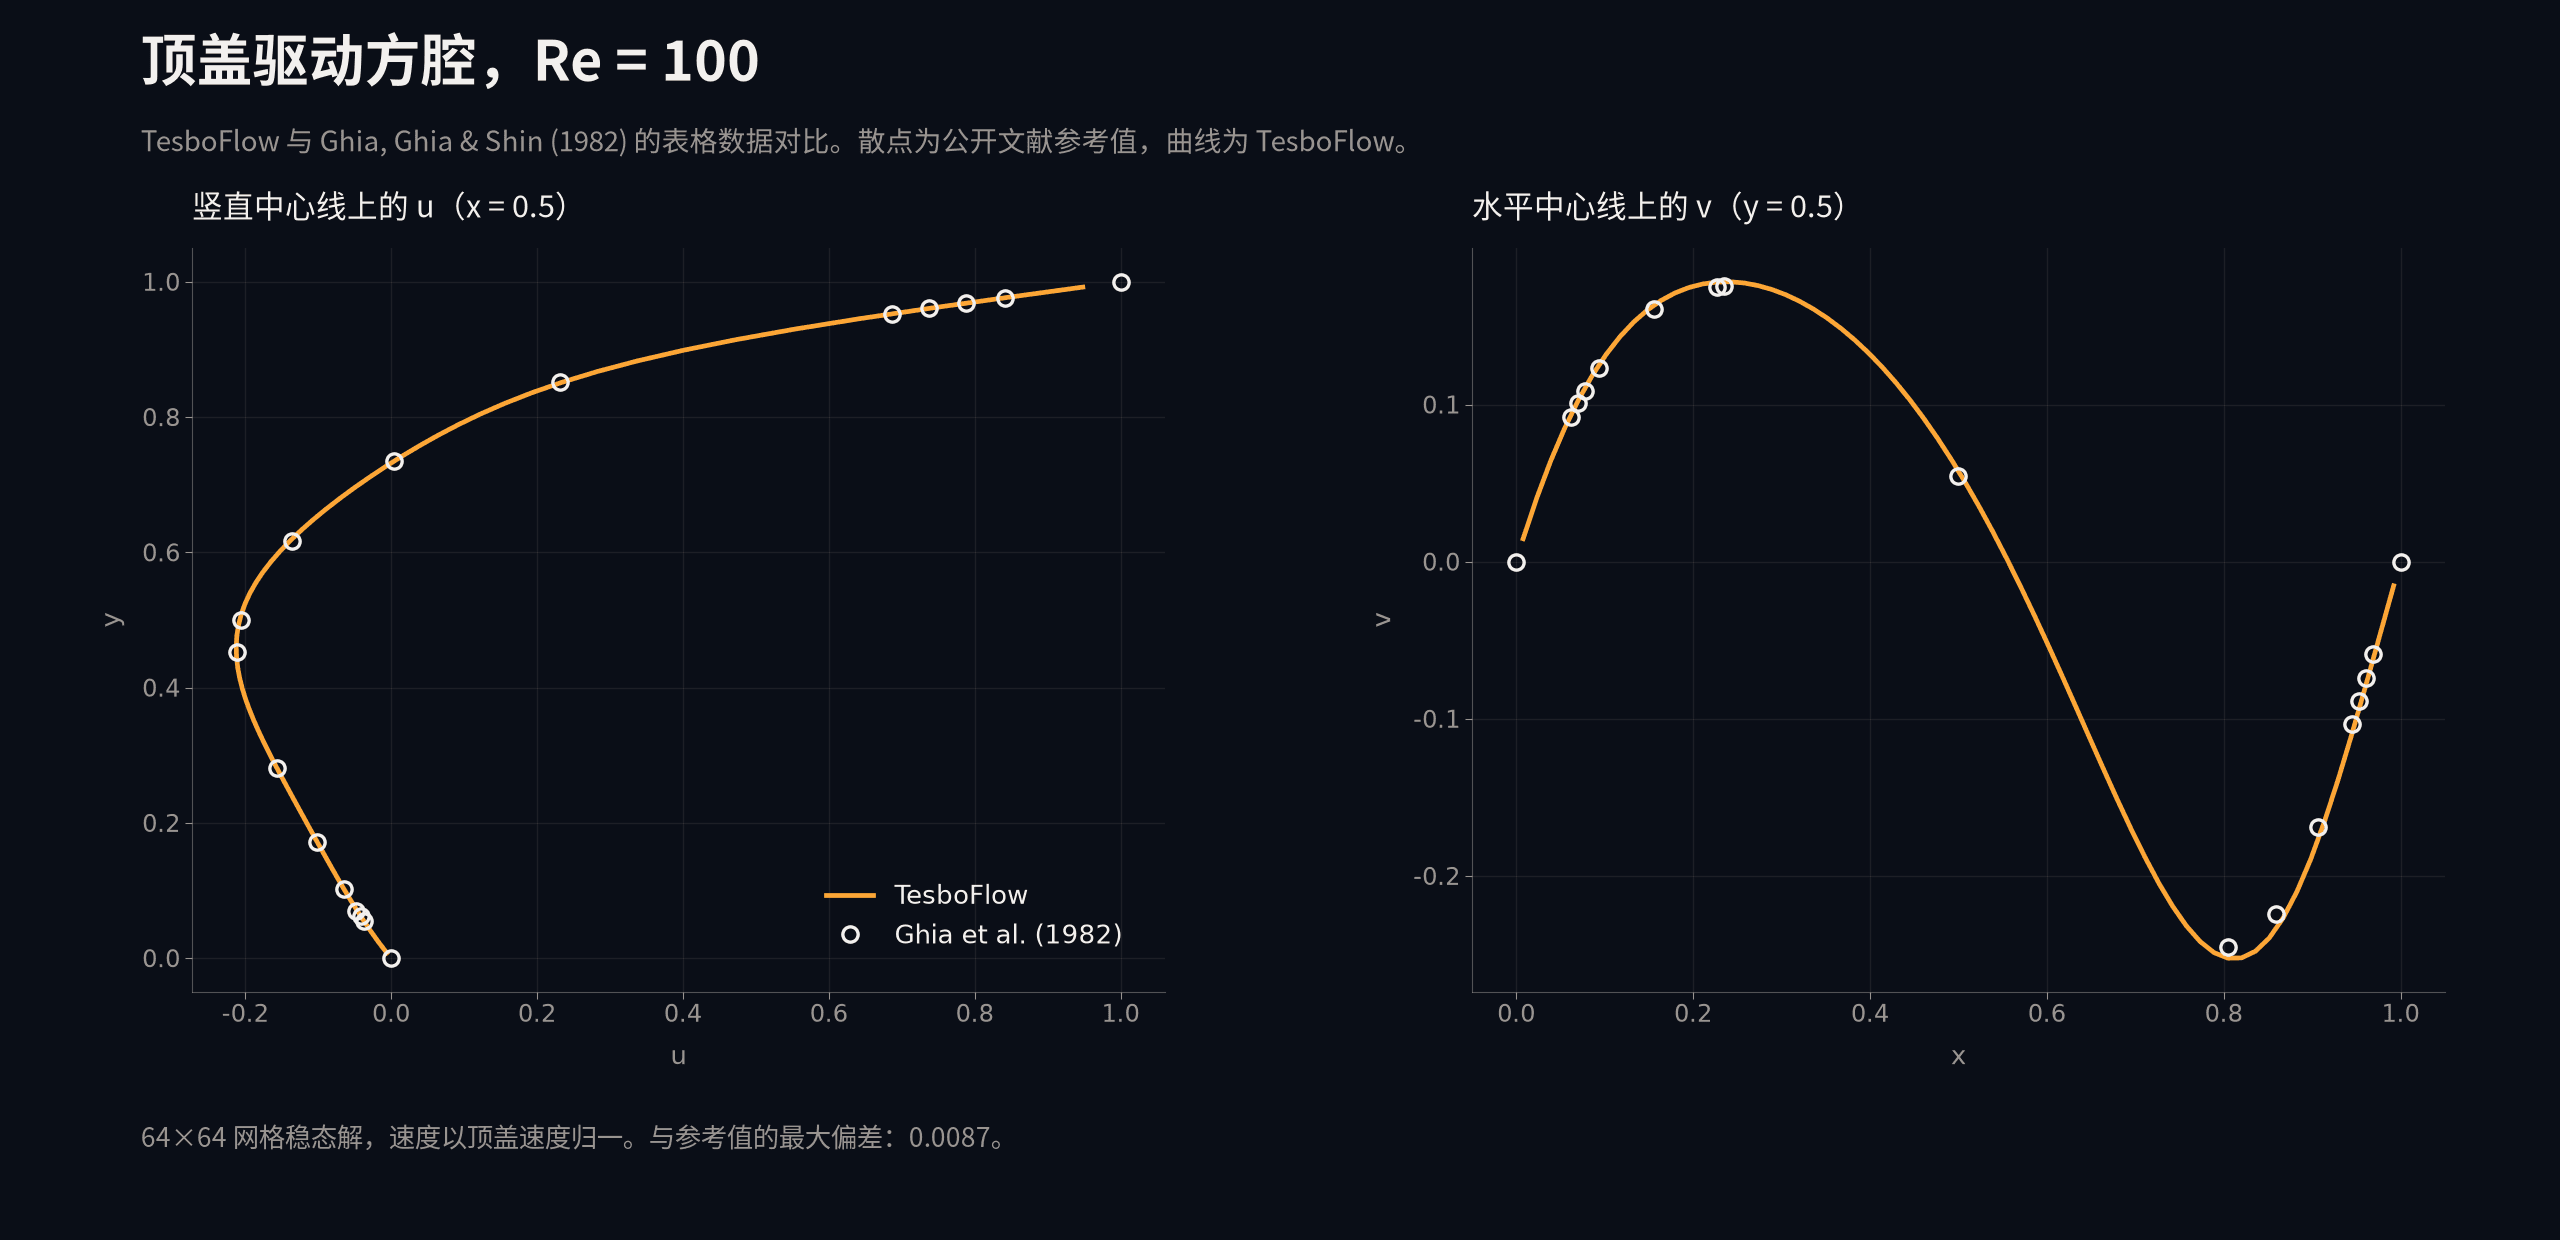
解析解与制造解
通道流与方腔流、周期流、瞬态与多层导热、表面张力、静水压、亚格子闭合。
公开文献基准
Ghia 顶盖驱动方腔,以及 Ahmed 25° 对 1984 / 2011 风洞带。
与独立求解器交叉对标
共轭传热与重叠网格湍流的逐场比对,以及同网格 Ahmed 阻力对 CPU 求解器(−0.2%)。
工作流程
从几何,到结果
三步,一条 GPU 流水线——网格、求解、后处理都在 GPU 上完成。
第 01 步
定义算例
导入网格——用 TesboMesh 生成 TesboFlow 能直接吃的网格,或用你已有的——再用一个算例配置文件描述物理与边界。
- TesboMesh 写出带命名边界的 TesboFlow 原生网格,也可导入常见格式
- 一个配置文件选定全部物理,无需换程序
- 算例分解,用于多卡运行
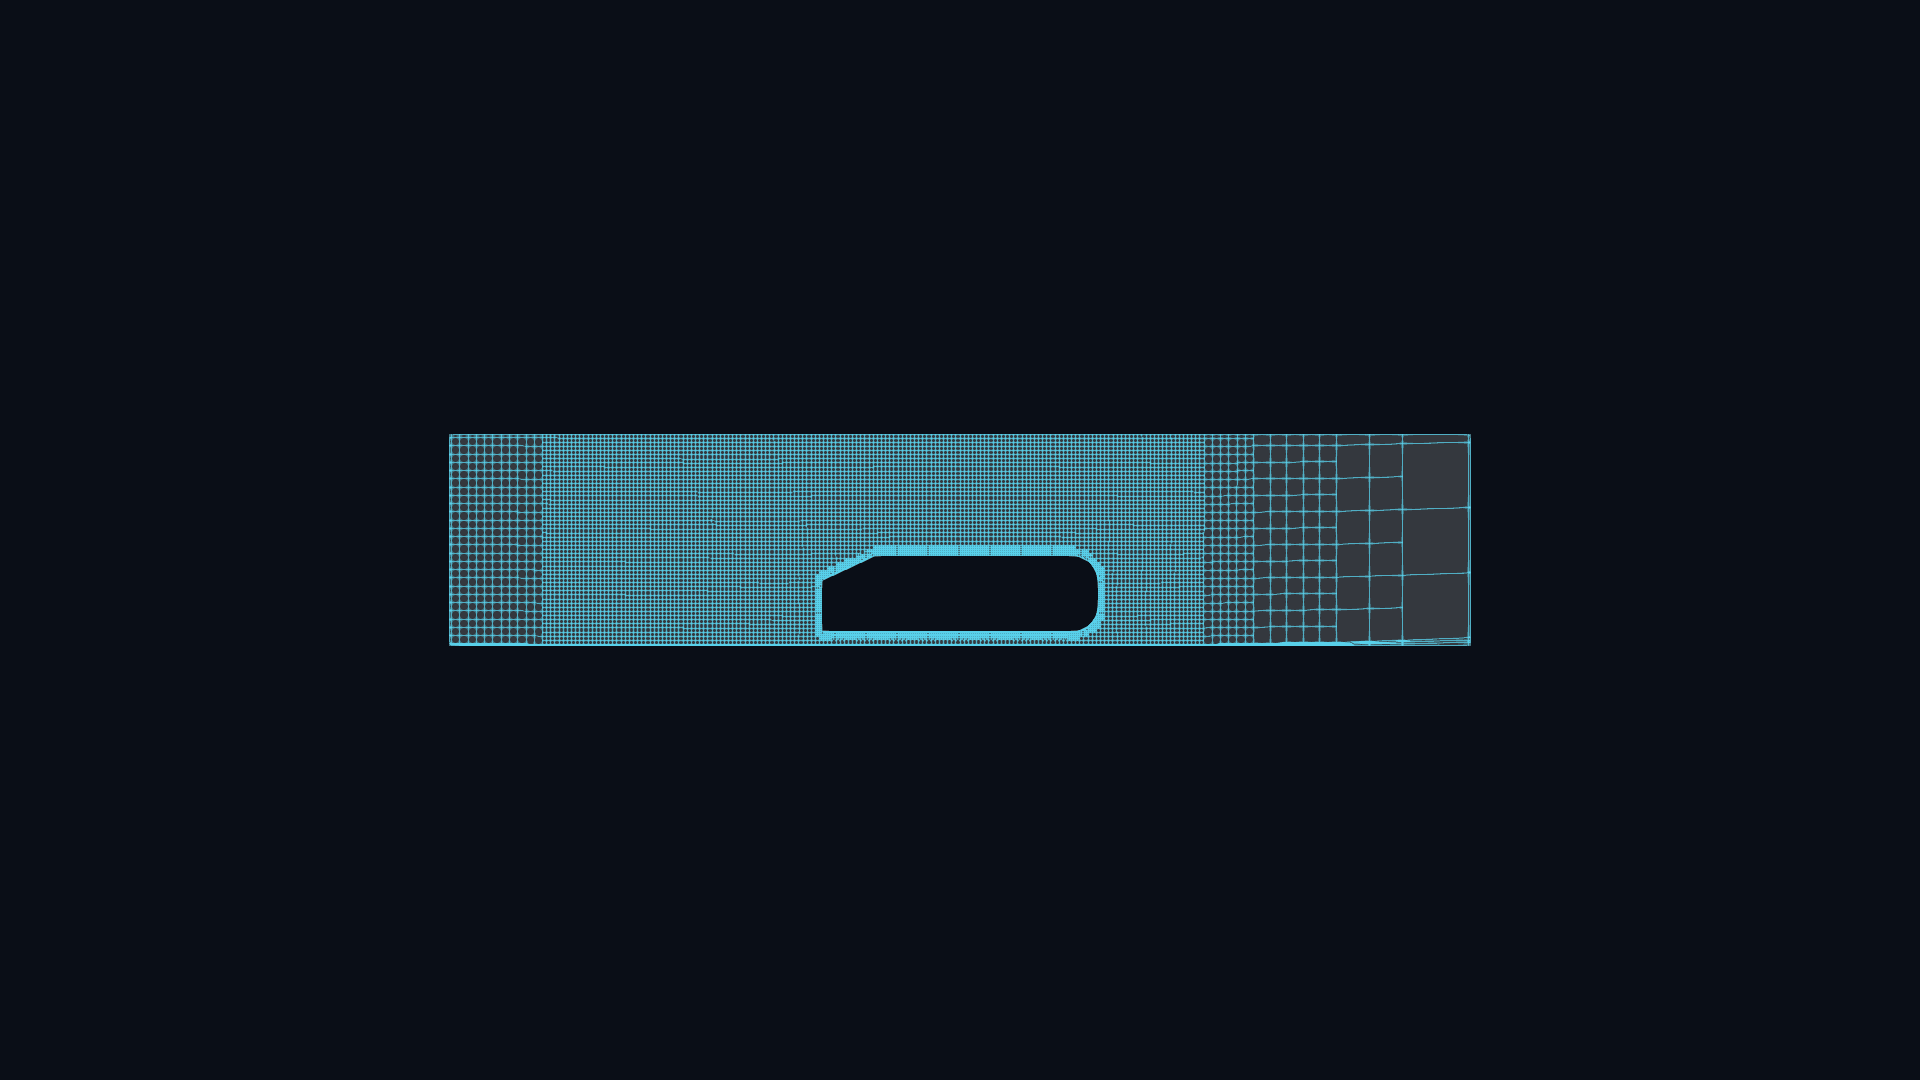
Ahmed 25°,109 万胞——求解器实际跑的网格中面
第 02 步
在 GPU 上求解
设定压力—速度耦合与湍流模型,整个求解过程都留在 GPU 上。
- SIMPLE / PISO / PIMPLE,稳态或瞬态
- RANS 与 LES,被动标量与传热
- 单卡到多卡,同一份程序
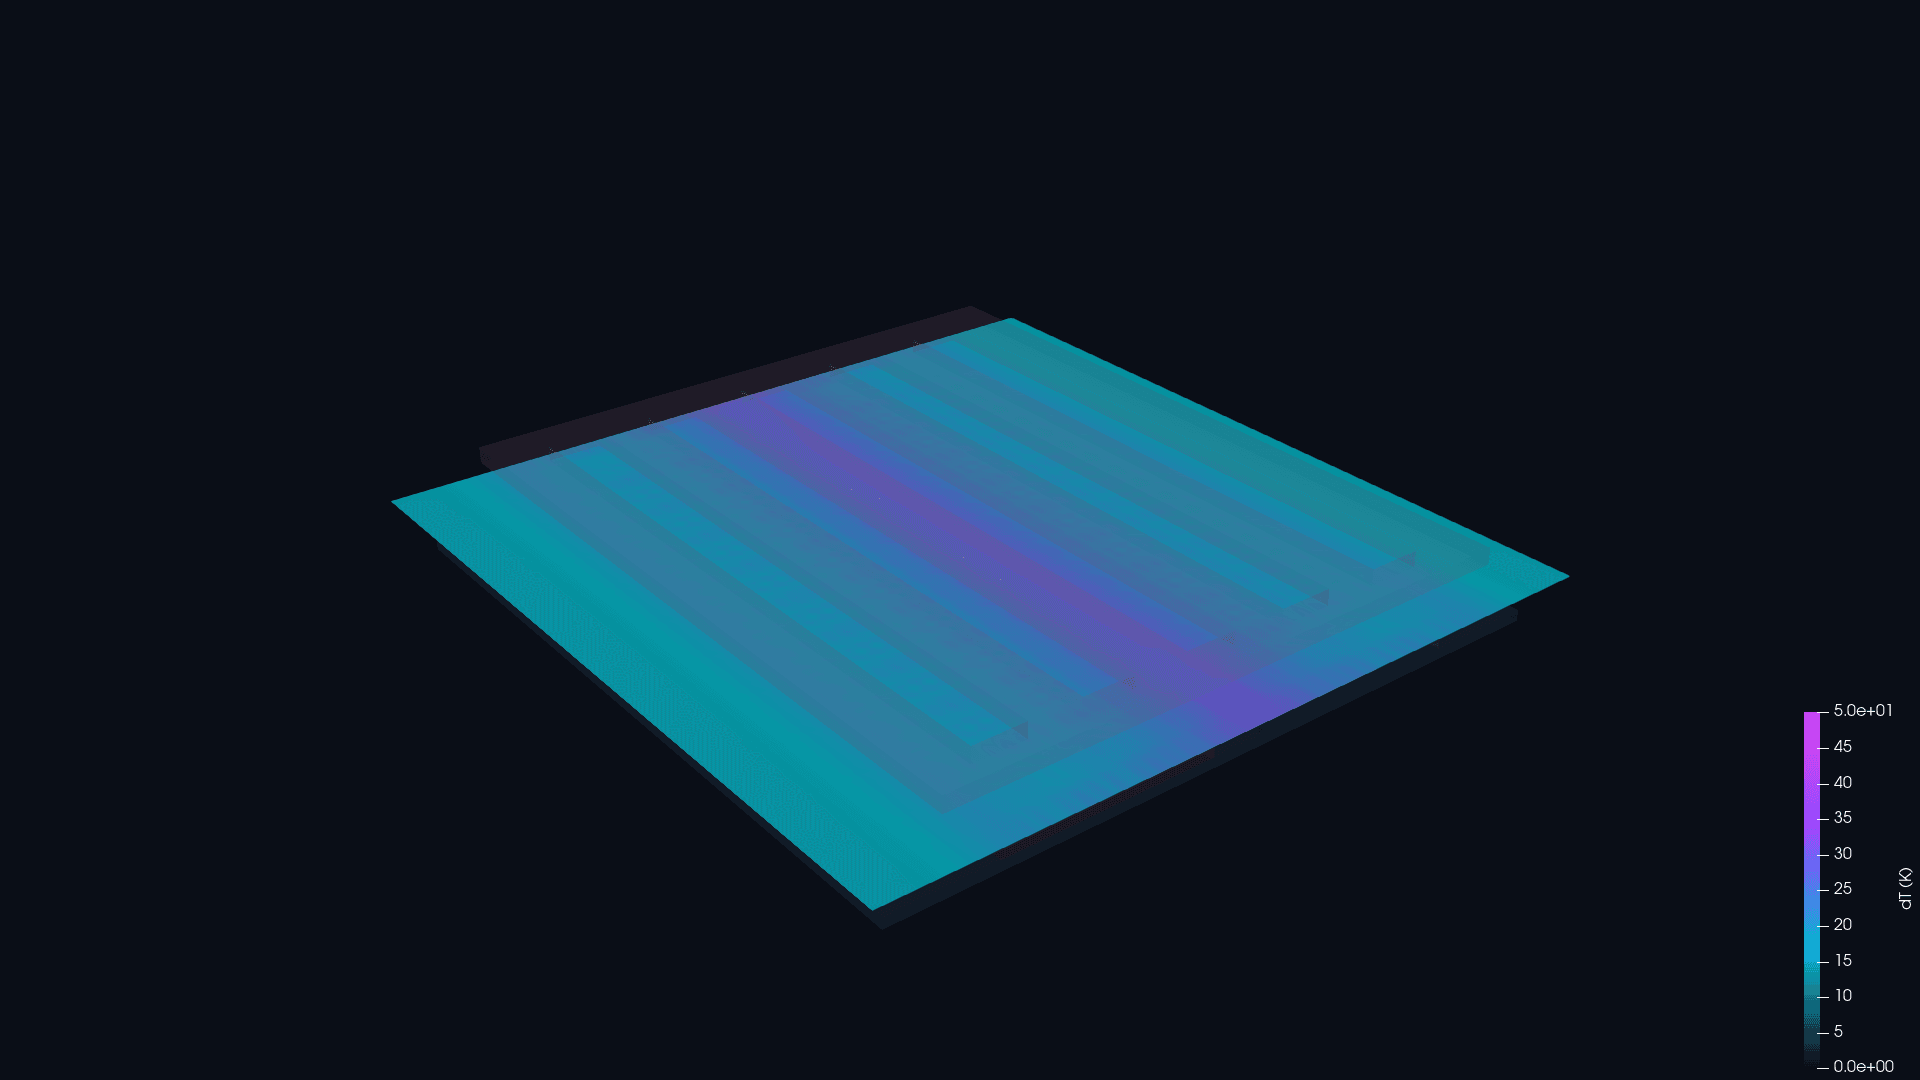
冷板温度场,在 GPU 上求出
第 03 步
导出与后处理
结果导出为通用格式,提取你关心的物理量。
- 可直接用 ParaView 等通用工具打开
- 力、气动系数与壁面量
- 运行时日志 + 一键支持包
球体流线——真正拿来看的场
能力
TesboFlow 能做什么
TesboFlow 现在能做什么。典型能力,不是合同。
物理
- 不可压流动(稳态 / 瞬态)
- 可压缩流动(压力基 / 密度基)
- RANS 湍流(k-ε、k-ω SST、壁函数)
- 大涡模拟(WALE、Smagorinsky、kEqn)
- 混合 RANS-LES(DES / DDES)
- 能量方程 / 传热
- 填料床 / 过滤器阻力(Darcy–Forchheimer)
- 被动标量输运(可多方程,也可只解标量)
- 多区域共轭传热(CHT)
- 多相流(VOF 自由界面)
数值
- 有限体积离散
- 压力—速度耦合:SIMPLE / PISO / PIMPLE
- 高分辨率对流格式
- 非正交网格修正
- GPU Krylov 求解器族(含多种预条件)
- 自研 GPU 代数多重网格
- 求解前快速初始化(改善起步收敛)
网格与边界
- 动网格 / 变形网格
- 重叠(嵌合)网格、多体
- 刚体运动
- 周期(cyclic)边界
- 常见网格格式导入 / 转换
并行与平台
- 全流程 GPU 原生
- 多 GPU(任意卡数)
- 多节点集群
- 确定性结果:同一算例每次运行结果一致
- 并行网格读取 + 单文件并行结果写出
- 同源纯 CPU 版本(无 GPU 环境可部署)
- 双精度内核,支持混合精度
- 本地 / 私有部署
工作流
- 单一可执行 + 算例配置文件驱动
- 结果导出
- 可直接用 ParaView 等通用工具打开
- 易脚本化,支持批量自动运行
交互体验
在浏览器里跑一个求解器
这个风洞是一个实时 GPU 流体求解器。选一个物体,在烟雾、速度、压力之间切换,或者自己画一个障碍物,实时看流场如何响应。
交互式风洞实验室
在风洞内拖动鼠标手动阻挡气流,实时观测 Navier-Stokes 流场。
GPU 稳定流体求解:512×256 网格,30 步 Jacobi 压力投影保证局部质量守恒(div U = 0),全程在 GPU 上运行。
架构
GPU 原生,而非移植
整条流水线都驻留在 GPU 上,因此每一步迭代都无需 CPU–GPU 往返。速度正来自于此——数据始终待在计算发生的地方。
通过区域分解在多块 GPU 上扩展。同一套代码,既能跑单卡,也能跑多卡,单机或跨集群皆可。
路线
现在已有,以及接下来
- 不可压流动稳态与瞬态求解器,在标准算例上完成验证。
- 湍流(RANS / URANS)业界标准的湍流建模。
- 尺度解析湍流面向非定常分离流的 LES 与 DES。
- 动网格运动与变形几何。
- 重叠网格用于复杂相对运动的重叠网格。
- 共轭传热多区域流固传热。本页有冷板和 JEDEC 的画面。
- 可压缩流动压力基与密度基。跨声速与超声速。
- 自由液面 VOFVOF 自由界面:溃坝、晃荡、注液。
- 接下来
- 自动化 API脚本化的设计扫描与流水线。
应用
用在哪里
航空航天设计
机翼与外形的外部空气动力学——在升力、阻力与尾迹结构上快速迭代。
汽车空气动力学
整车阻力与尾迹研究,配合动网格与重叠网格处理车轮等运动部件。
叶轮机械
旋转叶排与内部流道,用动网格或重叠网格求解。不做冻结转子(MRF)源项:转子是真的在转。
船舶水动力学
船体与推进器流动,周转时间决定你能测试多少个设计。
暖通与通风
房间与封闭空间内的气流、舒适度与污染物输运。
工业流体过程
混合、分配管路与内部流动,服务于设备设计与优化。
部署与支持
在你自己的硬件上运行,并有支持兜底
规划评估前需要知道的事:TesboFlow 在哪里运行、对机器有什么要求、运行失败时如何处理、团队如何上手。
本地部署
自包含的容器镜像或可迁移安装包,解压到普通目录即可,运行在你自己的工作站、服务器或集群上。无需另外安装依赖,也不需要管理员权限。
硬件与环境
Linux 搭配 NVIDIA GPU,覆盖 Volta 至 Hopper 代际。首次运行前可用环境自检确认驱动、GPU 与授权是否就绪。
技术支持
每次运行都会写出自描述日志,一条命令即可收集诊断包。部署协助与算例配置咨询随授权提供。
培训
面向工程团队的课程与教程,从第一个算例到生产流程。
网格可由 TesboMesh 生成:同一套边界名、同一道质量门、同一种文件。闭环——你送几何,我们回网格与质量报告,并可在 TesboFlow 里代跑。
看 TesboMesh