TesboFlow
几天的算例,一顿饭的工夫。
整条流水线都在 GPU 上。没有一步在等 CPU。
1 亿网格,算一步,花一秒。
实测:1.1 亿胞 · 8×A100 · 1.5 秒/步
0×
对单核 CPU
0×
对 18 核 CPU
产品矩阵
四个产品,一条 CFD 闭环。
两套 GPU 求解器,一个直接写出 TesboFlow 原生网格的前处理,再加上同一条管线上的 AI。
TesboFlow · 实测
性能
已经跑到这个速度。这块硬件,这些网格。
- 0×
- 对单核 CPU
- 0×
- 对 18 核 CPU
- 0.0 s
- 1.1 亿胞,一步
套件目标仍是 1000×、典型十分钟、一份程序从 1 张卡到 N 张。
实测 · TesboFlow,2026 年 9 月
每步墙钟
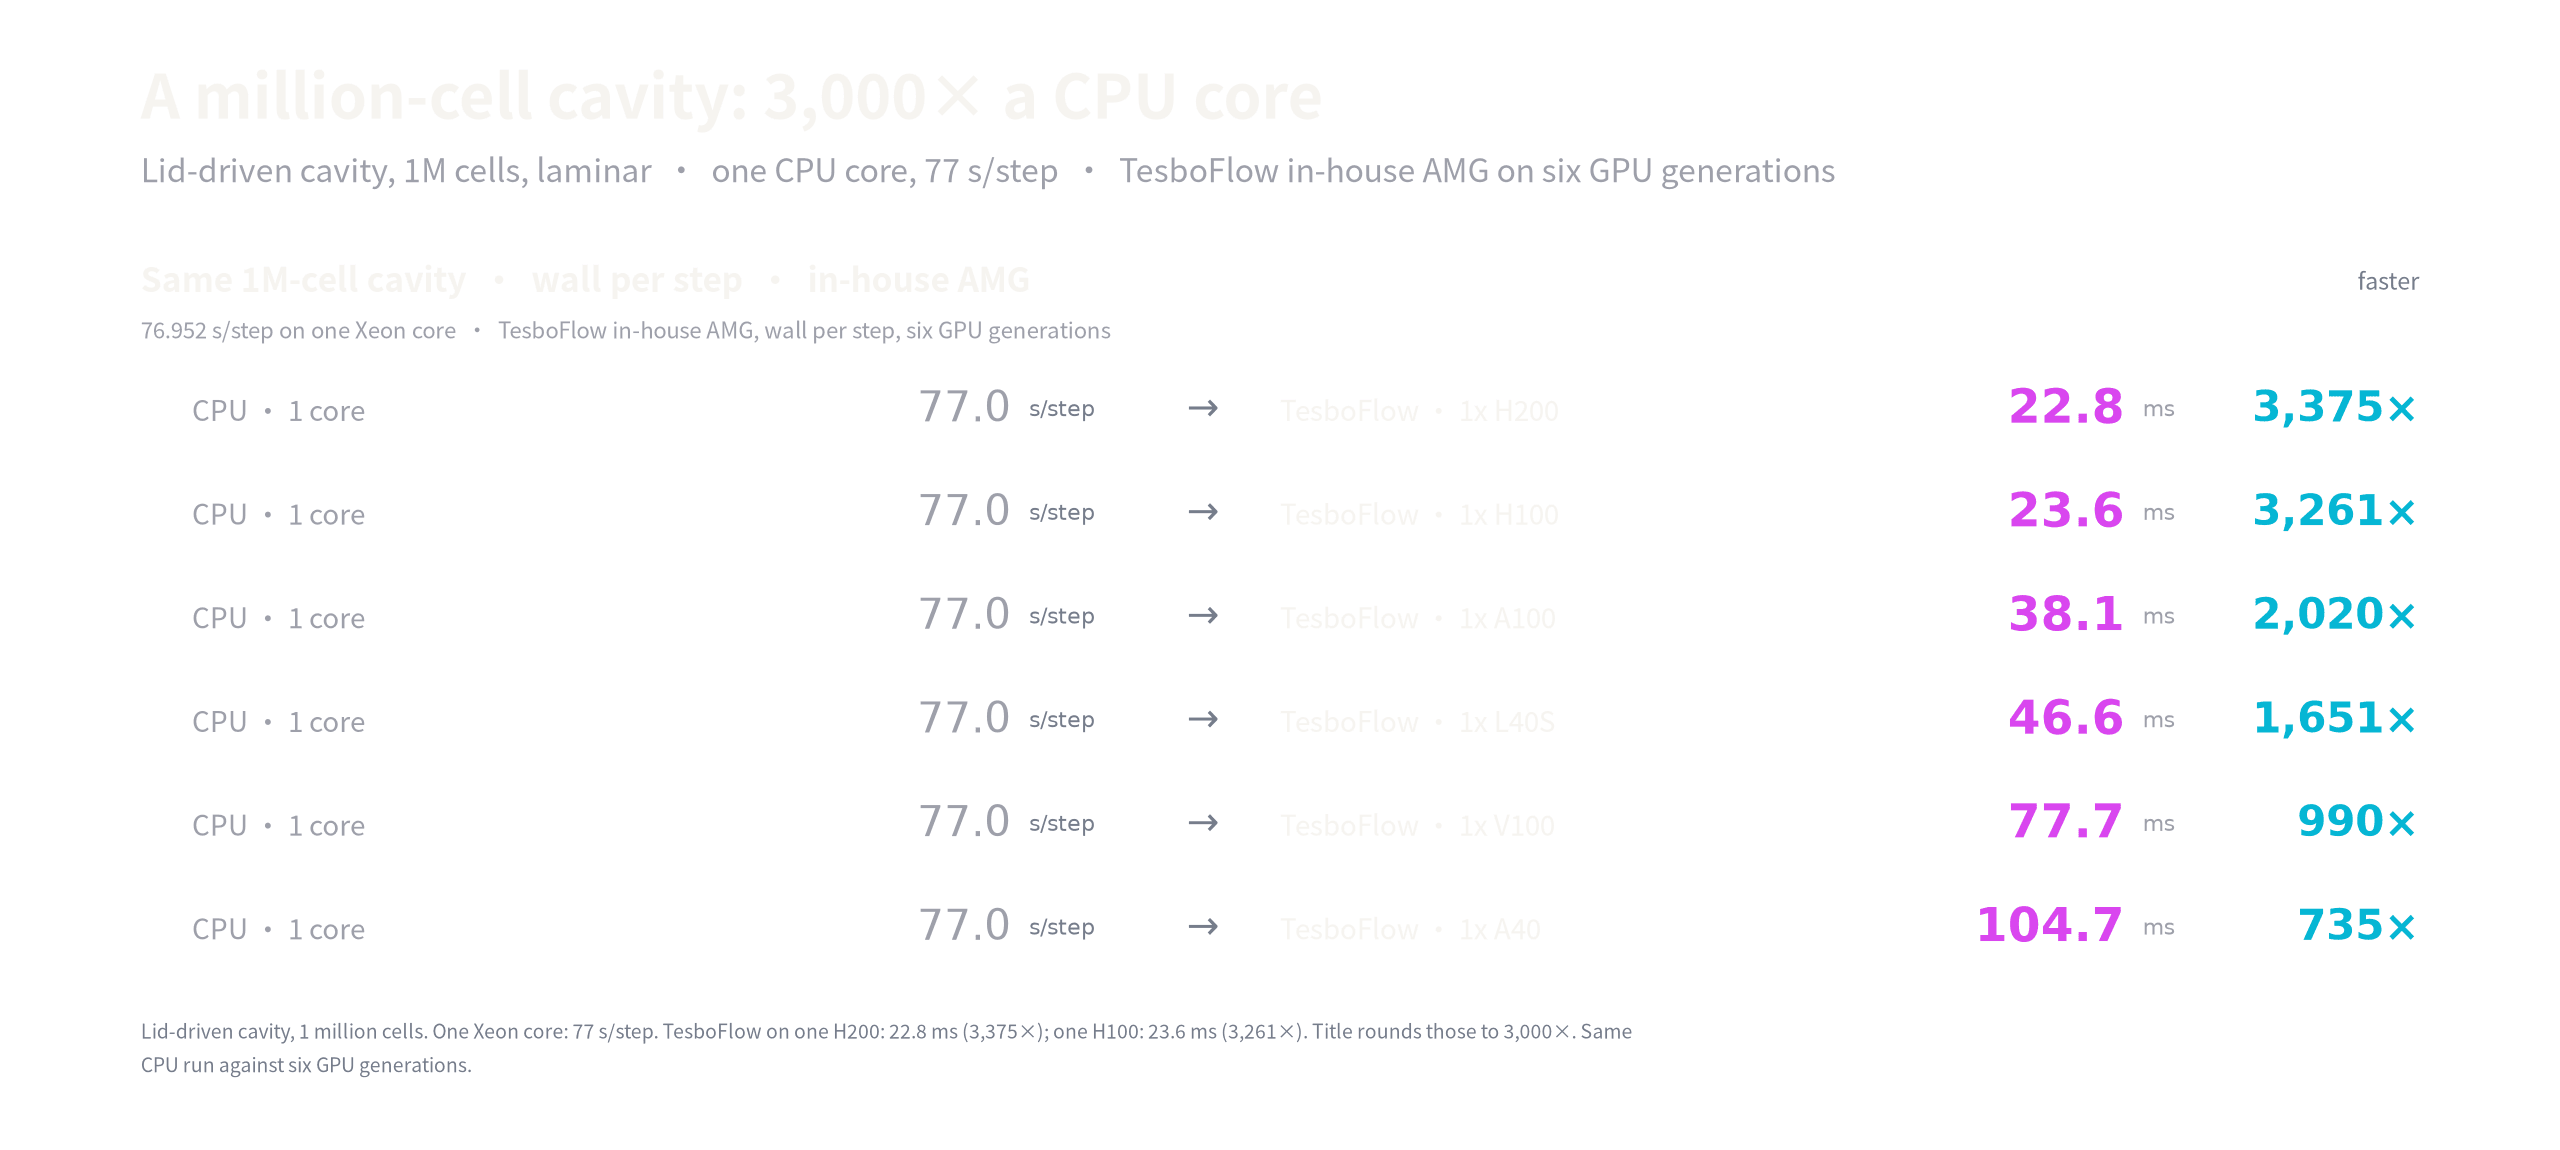
百万胞顶盖驱动方腔,层流——单核 CPU 对一张 GPU
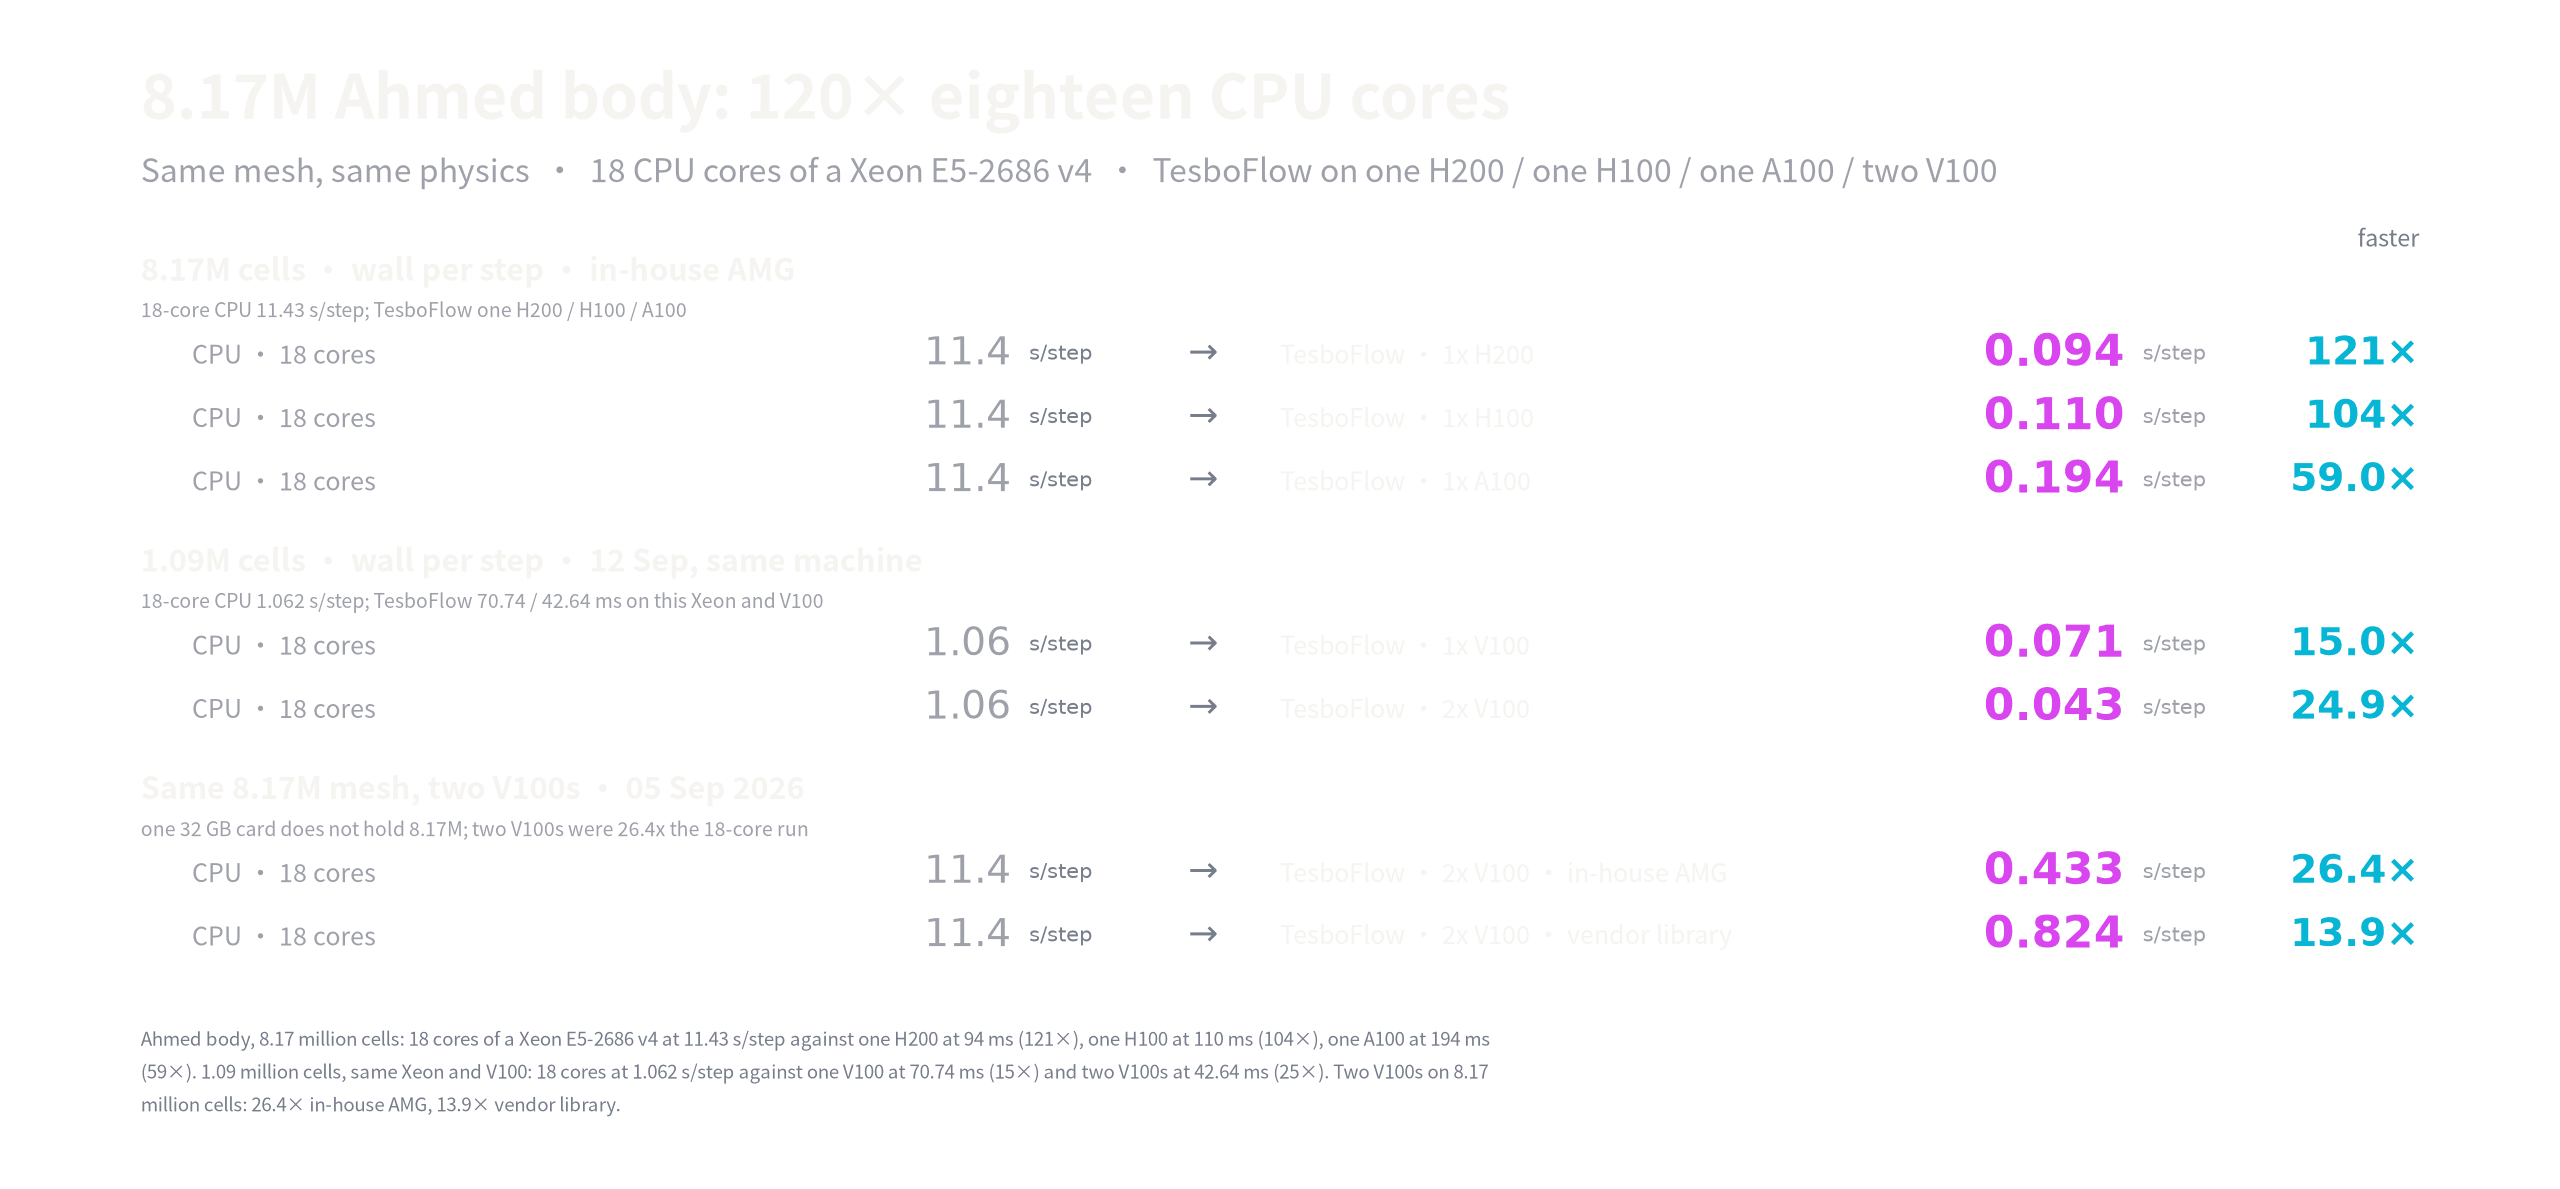
817 万胞 Ahmed,定常 RANS——18 核 CPU 对一张 GPU
1 亿网格,算一步,花一秒。
1.1 亿胞 · 8× A100 · 1.5 秒/步
实测:每步 1.5 秒。
典型场景,不是合同。3,000×:百万胞方腔,单核 CPU,一张 H200 22.8 ms。100×:817 万胞 Ahmed,18 核至强,一张 H200 94 ms。1.1 亿胞,8 张 A100,每步 1.5 秒。
TESBOLBM · 实测
铸造仿真,跑在 GPU 的速度上
- 0×
相对单个 CPU 核
单卡 Tesla V100 上 1851 MLUPS,对同机单核的 4.1 MLUPS。
- 0×
相对整机 CPU
同一次 GPU 运行,对该机器 18 核全开跑 MPI 的 33.9 MLUPS。这是我们对外用的数字。
- 0.0×
传热核上
5422 MLUPS 对 36 线程 CPU 的 134 MLUPS,两侧跑同一套算术。
同一台机器、同一块 Tesla V100、两侧同一个核,没有缩放也没有外推。整机的倍数远低于单核倍数,是因为 CPU 自己从 1 核到 18 核只快 8.3 倍——格子玻尔兹曼受限于内存带宽,不是主频。
让计算更快
GPU 原生架构
TesboFlow 将整个 CFD 流程运行在 GPU 上——网格、求解器、线性代数、后处理。无 CPU 瓶颈,无数据传输开销,纯并行计算。
- 无 CPU 瓶颈
- 大规模并行
- 高内存带宽
同一套 GPU 原生做法也用在 TesboLBM 上 —— 铸造的充型与凝固同样整程跑在 GPU 上。
了解 TesboFlow为什么选择 TesboFlow
不是移植。GPU 原生有限体积求解器,已经跑到这个速度、这块硬件、这些网格。
自研 AMG
比 NVIDIA AmgX 更快更省。一千步 35 秒对 59 秒,7 焦耳对 11 焦耳。
加卡,墙钟还在掉。
单卡装不下的网格,加卡仍然更便宜。5600 万胞,多出来的卡划得来。
Ahmed 车体 · 湍流尾迹 · 由 GPU 计算
实时 Navier-Stokes 风洞
就在浏览器里,实时求解。选一枚翼型、一根圆柱,或亲手画下一道壁面,看涡与压力波如何演化。
TesboAI · AI + CFD 研究
让智能,生长在求解器里。
因为引擎是 GPU 原生的,模型在它的数据上训练、在它的显存里运行。这里给的是结果,不是承诺。
你
TesboAI
相对 L2 误差 0.194 · 容差 0.25
会话重演 —— 提问、改条件、比较方案;每个数字都由 GPU 求解器算出。
研究原型,开发中。此处是一次真实会话的短版重演 —— 完整会话见 TesboAI 页。
GPU 时代的仿真
为速度而生,由 GPU 驱动。
速度不是一项功能,而是仿真能否被真正用起来的关键。当一个结果只需数分钟而非数天时,工程师便不再等待,而是开始探索。我们从零起就为 GPU 而造,让这成为常态。
这会改变世界。
— Tesbo,项目创始人
关于 TesboCFD
TesboCFD 致力于开发下一代 GPU 原生 CFD 技术,服务于工程仿真与 AI 辅助设计。
学术科研与求解器验证合作机构